1.2 Programming Model
本节从与具体编程语言无关的角度介绍 CUDA Programming Model。这里建立的术语和概念适用于 CUDA 支持的各种编程语言,后面的章节再具体介绍这些概念如何通过 C++ 等语言表达。
CUDA Programming Model 建立在 CPU + GPU 的异构计算系统之上:程序从 Host 开始运行,由 CPU 负责控制程序流程、数据传输和 Kernel Launch,而 GPU 负责通过大量 Threads 并行执行 Kernel。
GPU 在硬件层面可以抽象为:
GPU
↓
GPC
↓
SM
而 CUDA Kernel 的并行执行结构则可以理解为:
Kernel
↓
Grid
↓
Cluster(Optional)
↓
Thread Block
↓
Warp
↓
Thread
Thread Block 是 CUDA 中非常重要的独立调度单位,同一个 Block 的 Threads 在同一个 SM 上执行并可以通过 Shared Memory 和 Synchronization 相互协作;不同 Blocks 默认必须能够独立执行,从而使 Grid 可以扩展到不同规模的 GPU。Block 内部的 Threads 又以 32 Threads = 1 Warp 的形式按照 SIMT 模型执行,因此 Warp Divergence、Memory Coalescing 等很多 CUDA 性能问题本质上都与 Warp 有关。
除了传统的 SIMT Programming,CUDA 还提供 Tile Programming Model,允许程序员以 Block 和多维 Tile 为单位描述计算,并将 Thread-Level Mapping 交给 Compiler。SIMT 强调细粒度 Thread Control,而 Tile Programming 提供更高层的 Data-Parallel Abstraction,两种模型可以在同一个 CUDA Application 中共存。
最后,CUDA Programming Model 还包含完整的 GPU Memory Hierarchy。GPU 具有 Global Memory、L2 Cache、L1 Cache、Shared Memory 和 Registers 等不同层级的 Memory Resources;不同层级具有不同的访问范围和硬件位置。CUDA 既允许程序员显式管理 CPU/GPU Memory 和 Data Transfer,也提供 Unified Memory 自动管理部分 Data Placement。高性能 CUDA Programming 的核心最终就是同时理解和利用这两条层次结构:
Execution Hierarchy
Grid → Block → Warp → Thread

Memory Hierarchy
Global Memory → L2 → L1 / Shared Memory → Registers
1.2.1 Heterogeneous Systems
CUDA 假设程序运行在一个 Heterogeneous System(异构计算系统) 中,也就是系统同时包含 CPU 和 GPU。CPU 及其直接连接的内存称为 Host 和 Host Memory,GPU 及其直接连接的内存称为 Device 和 Device Memory。一个系统中也可能存在多个 CPU 或多个 GPU。
CUDA 应用始终从 CPU 开始执行,其中运行在 CPU 上的代码称为 Host Code。Host Code 可以通过 CUDA API 在 Host Memory 和 Device Memory 之间移动数据、启动 GPU 上的计算,以及等待数据传输或 GPU 计算完成。CPU 和 GPU 可以同时执行任务,因此通常需要尽可能同时利用二者的计算资源。
运行在 GPU 上的代码称为 Device Code。被启动到 GPU 上执行的函数称为 Kernel,启动 Kernel 的过程称为 Kernel Launch。一次 Kernel Launch 通常意味着启动大量 GPU Threads,让这些线程并行执行同一个 Kernel。
CUDA Application

Host / CPU
│
│ Host Code
│
├── Allocate / Copy Data
├── Launch Kernel
└── Synchronize
        ↓
Device / GPU
│
│ Device Code
│
└── Many Threads execute Kernel
1.2.2 GPU Hardware Model
从 CUDA Programming Model 的角度,可以把 GPU 看作由大量 Streaming Multiprocessors(SM) 组成,多个 SM 又可以组织成 Graphics Processing Cluster(GPC)。每个 SM 内部包含自己的 Register File、Unified Data Cache 以及执行实际计算的 Functional Units,其中 Unified Data Cache 为 L1 Cache 和 Shared Memory 提供物理资源。不同 GPU 架构中的 SM 数量、Functional Units 数量以及各种存储空间大小可能不同。
CUDA Programming Model 并不要求程序依赖某个 GPU 的具体物理实现,因此不同 GPU 架构可以采用不同的内部硬件布局,只要它们保持 CUDA Programming Model 所规定的行为即可。
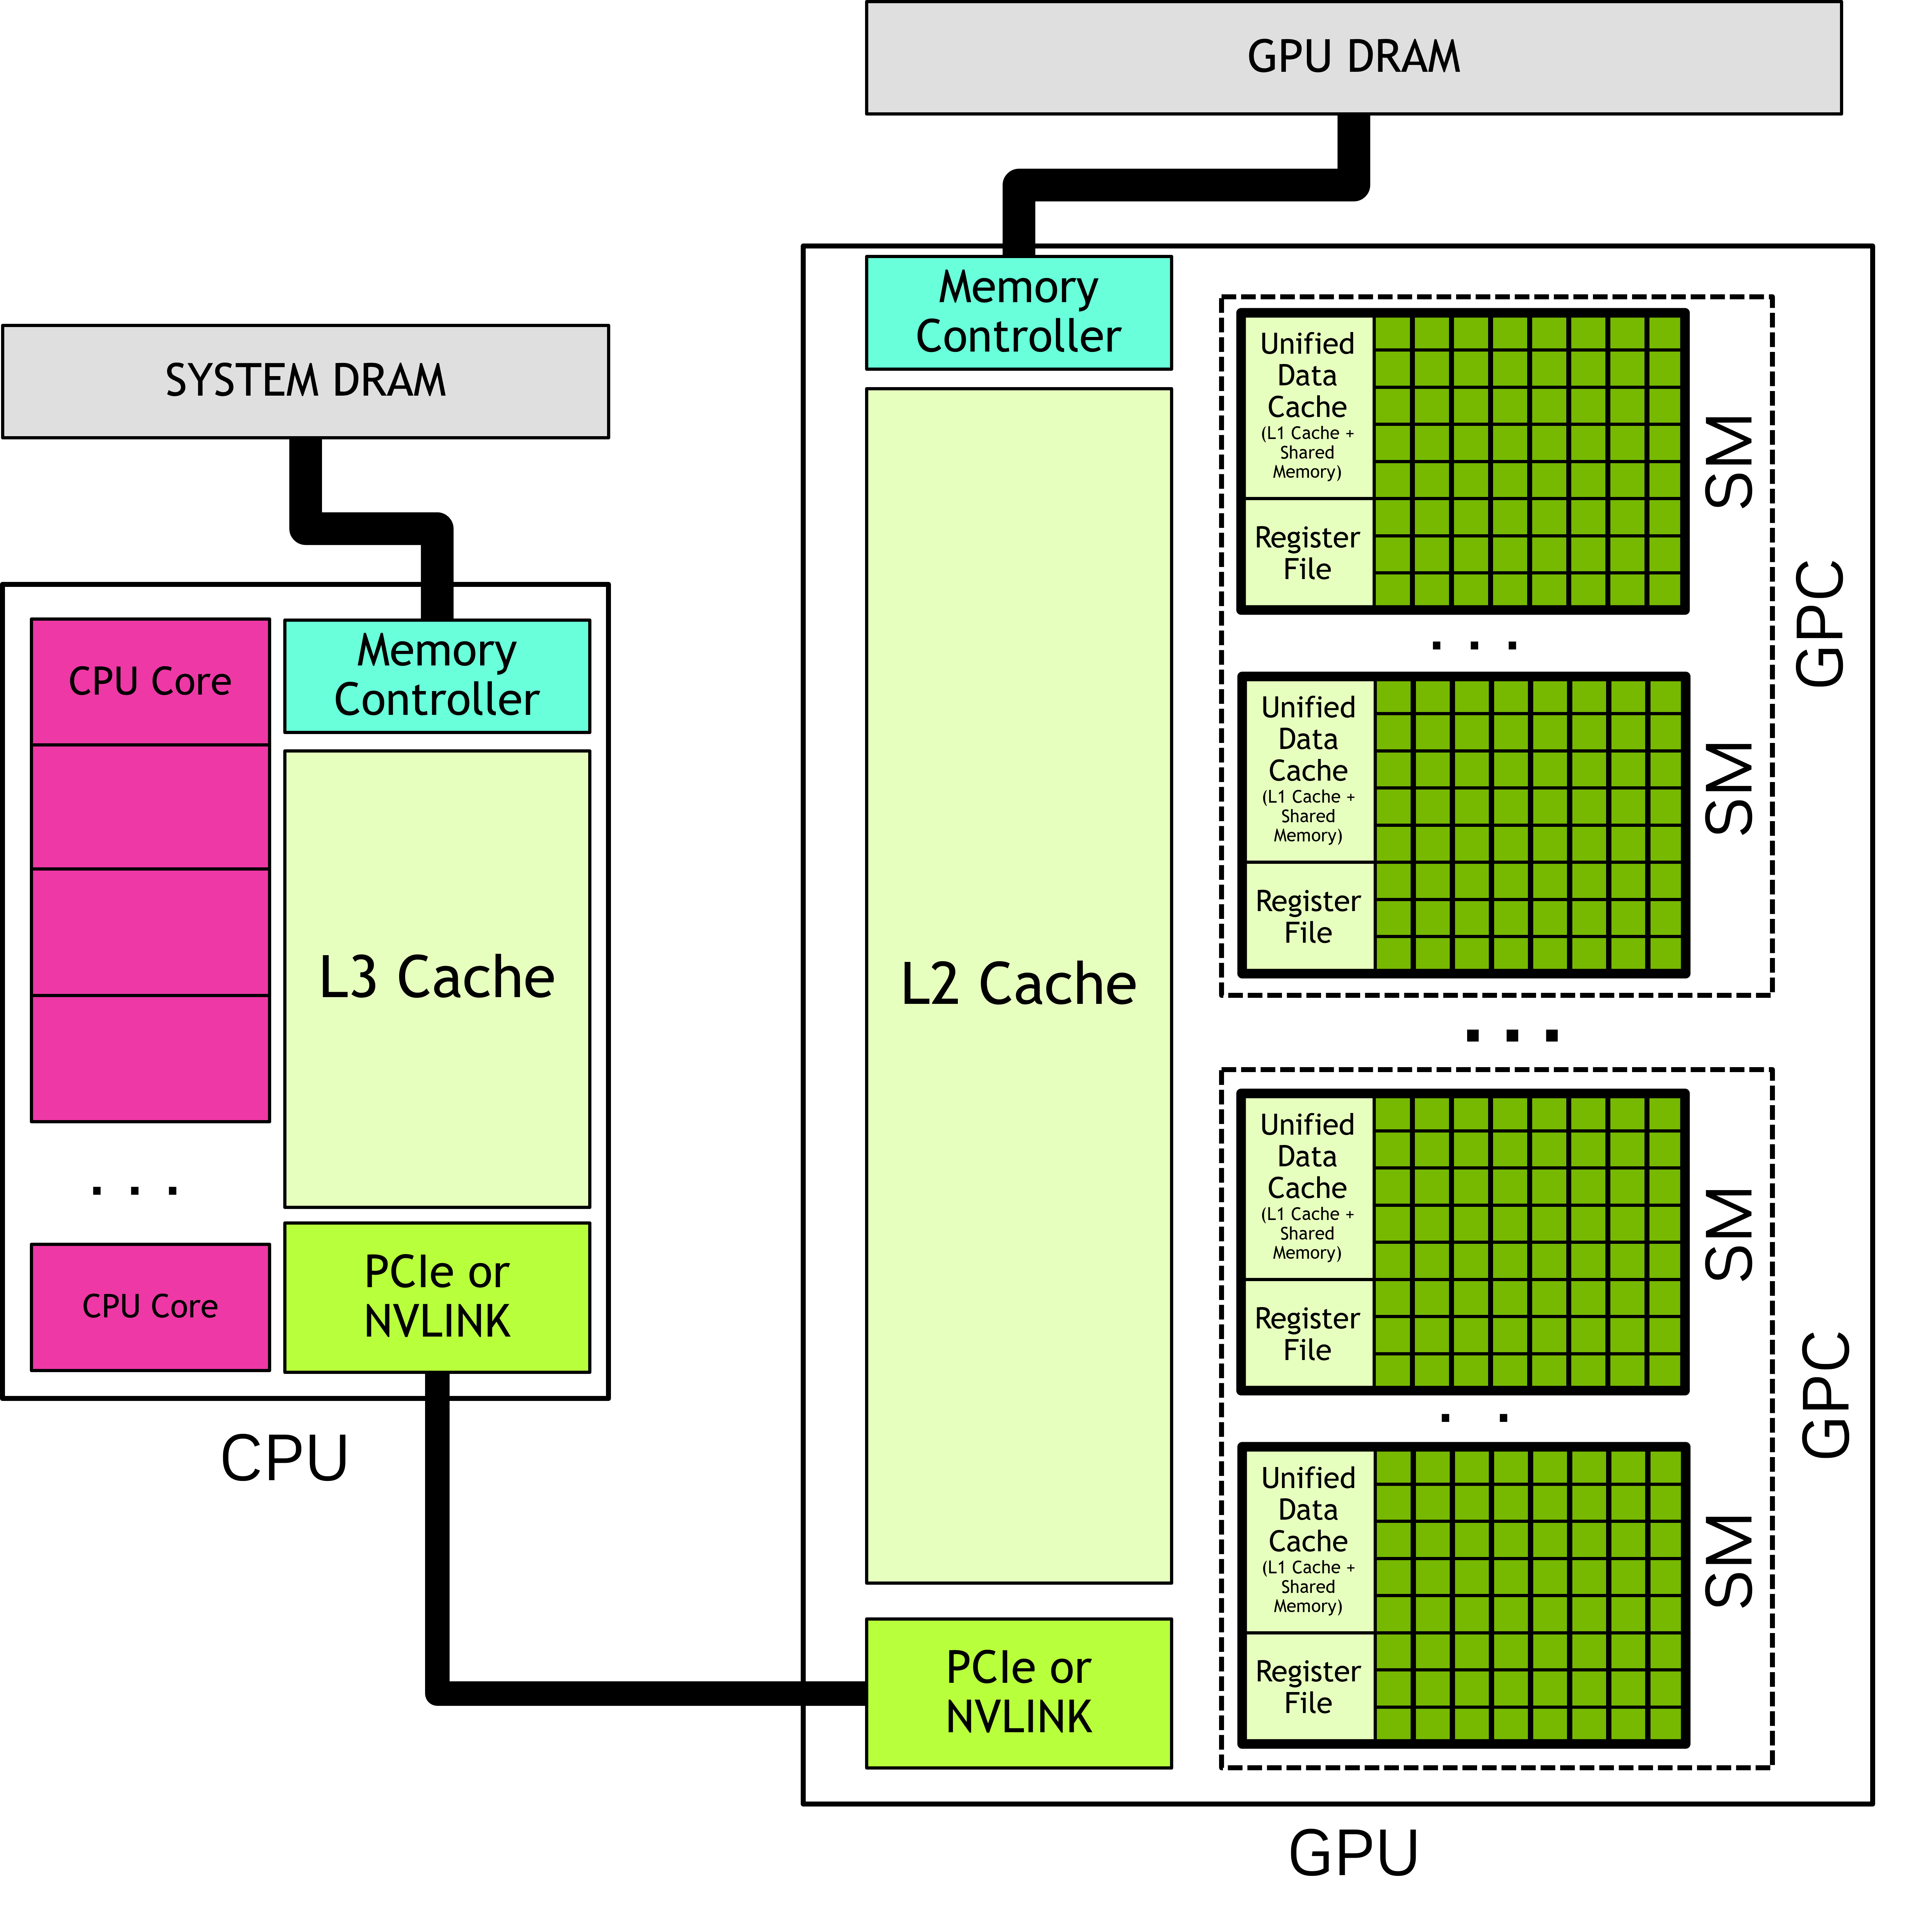
图2:GPU 包含多个流式多处理器(SM),每个 SM 都包含多个功能单元。图形处理集群(GPC)是由多个 SM 组成的集合。GPU 由一组连接到 GPU 内存的 GPC 构成。CPU 通常具有多个核心以及一个连接系统内存的内存控制器。CPU 和 GPU 通过 PCIe 或 NVLINK 等互连方式连接。
1.2.2.1 Thread Blocks and Grids
一次 Kernel Launch 通常会创建大量 Threads,甚至可能达到数百万个。CUDA 不会把这些线程作为一个完全扁平的集合管理,而是将它们组织成层级结构:
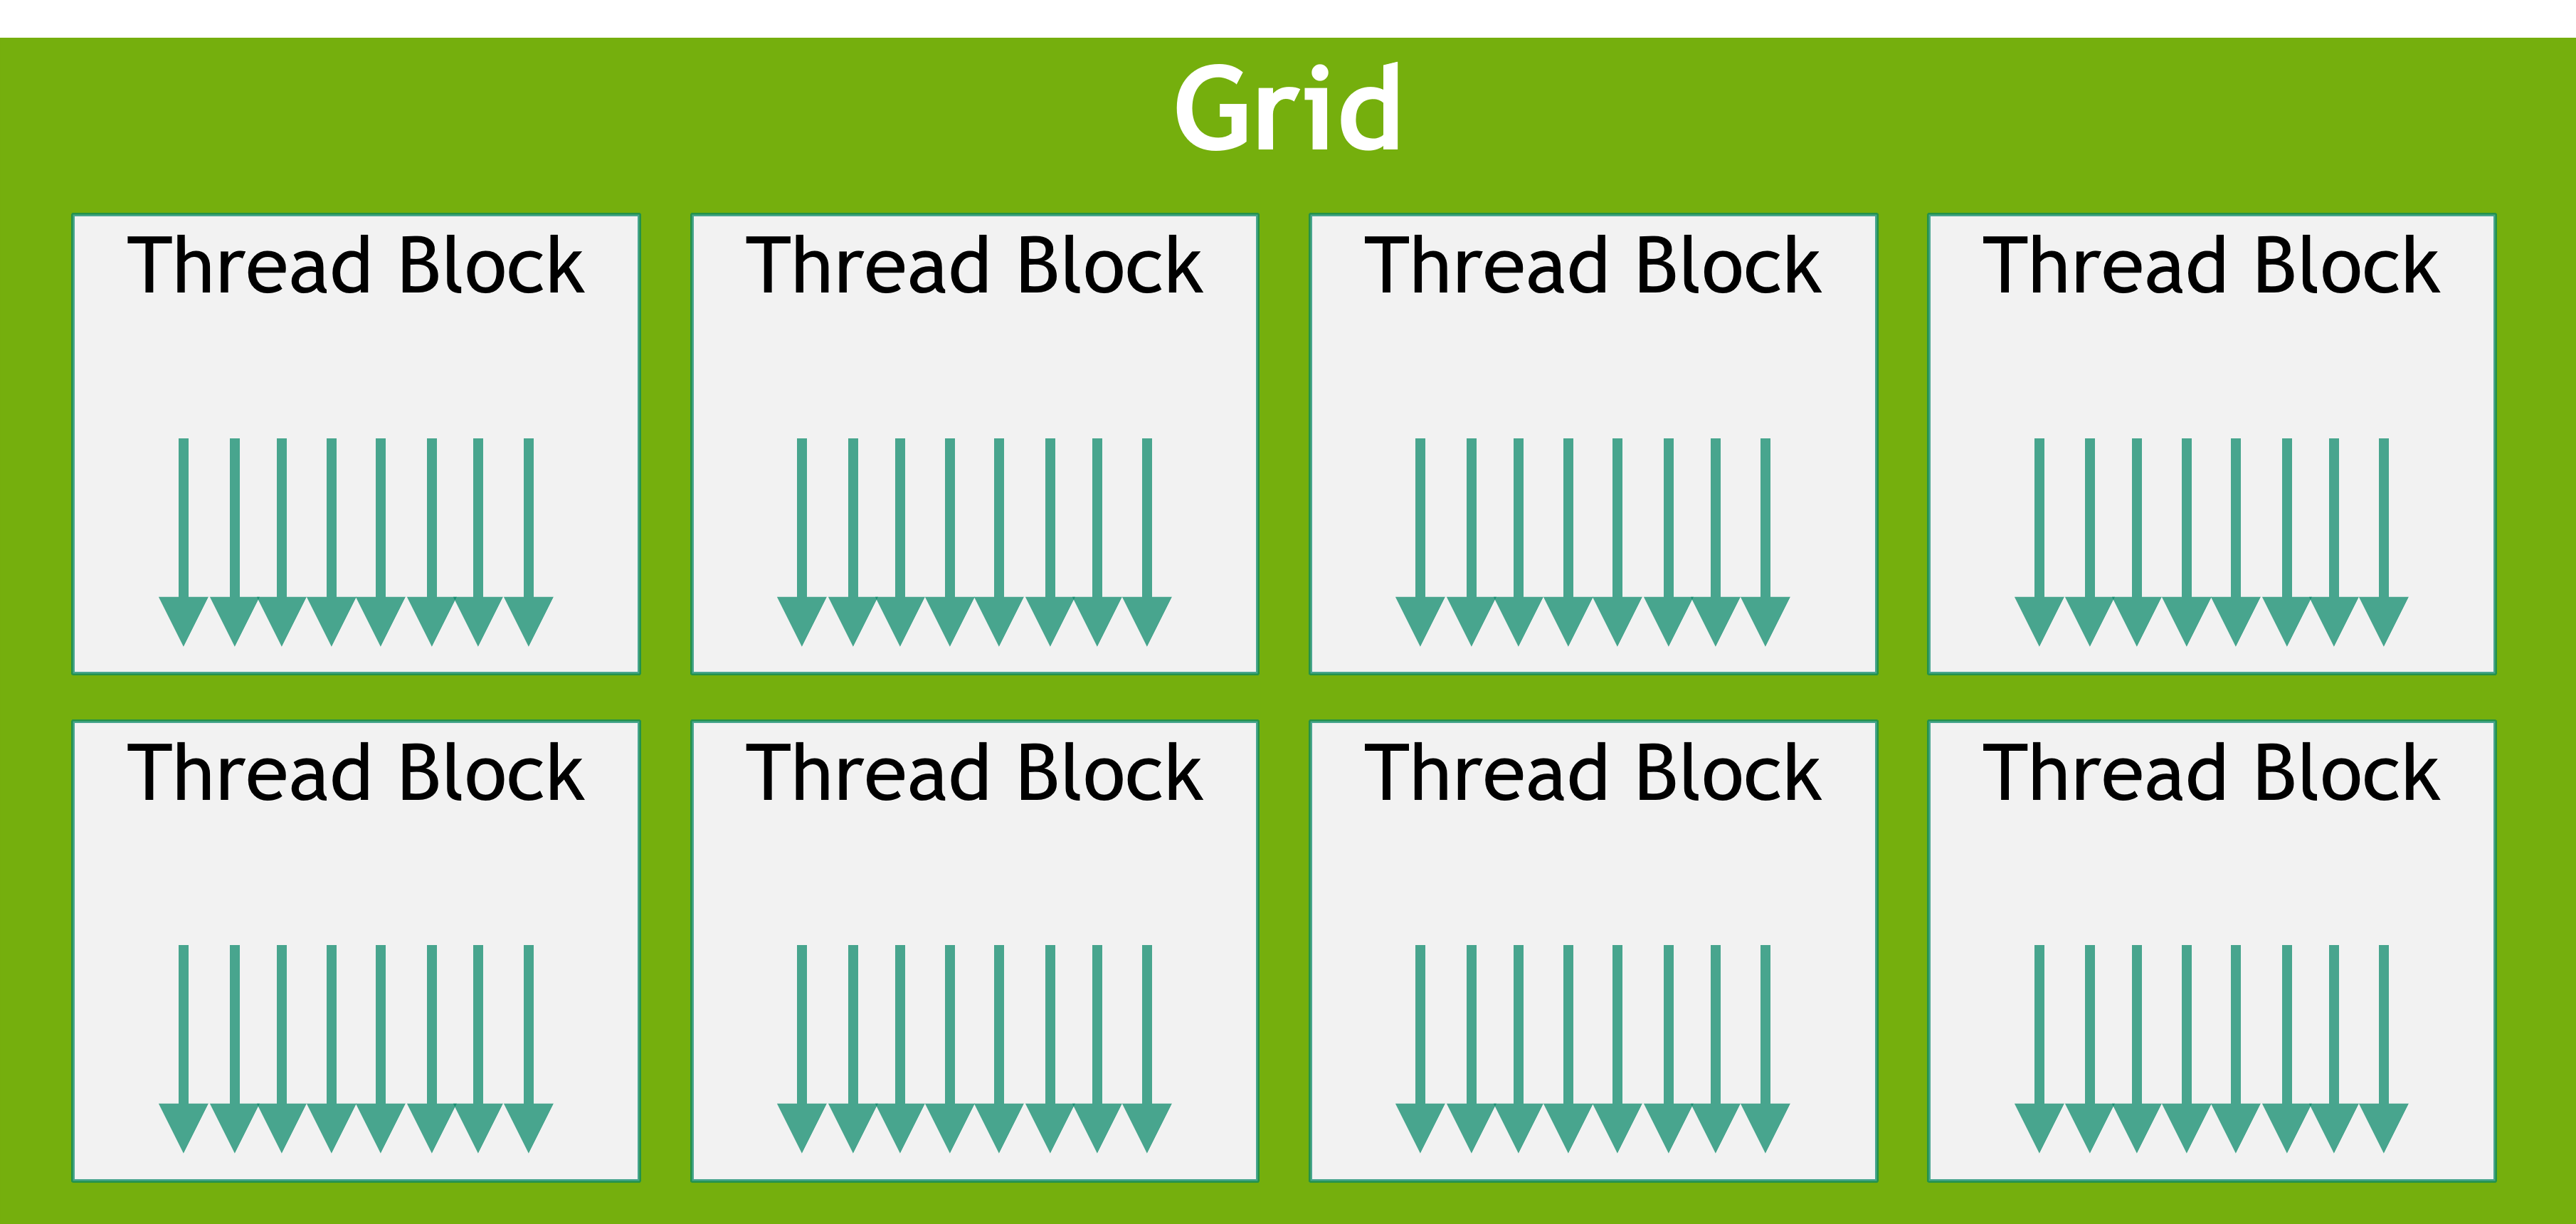
图3 线程块网格。每个箭头表示一个线程(箭头数量并不代表实际线程数量)。
多个 Threads 组成一个 Thread Block,多个 Thread Blocks 又组成一个 Grid。同一个 Grid 中所有 Thread Blocks 具有相同的尺寸和维度。Thread Block 和 Grid 都可以组织成 1D、2D 或 3D,这样可以更加自然地把线程映射到 Vector、Matrix、Image、Volume 等不同维度的数据上。
启动 Kernel 时,需要指定一个 Execution Configuration,其中最重要的是 Grid 和 Thread Block 的维度。每个 Thread 都可以通过 CUDA 提供的内置变量确定自己在 Block 中的位置,以及所属 Block 在 Grid 中的位置,从而获得唯一的线程身份,并据此确定自己负责处理哪一部分数据。
一个 Thread Block 中的所有 Threads 都会在同一个 SM 上执行,因此同一个 Block 内的 Threads 可以高效地进行通信和同步,并共同访问该 SM 上的 Shared Memory。
Grid 中可能包含数百万个 Thread Blocks,而 GPU 可能只有几十或几百个 SM,因此所有 Blocks 不可能同时执行。CUDA Runtime 会不断将 Blocks 调度到可用 SM 上执行,同一个 SM 还可能同时驻留多个 Blocks。CUDA 不保证不同 Blocks 的执行顺序。
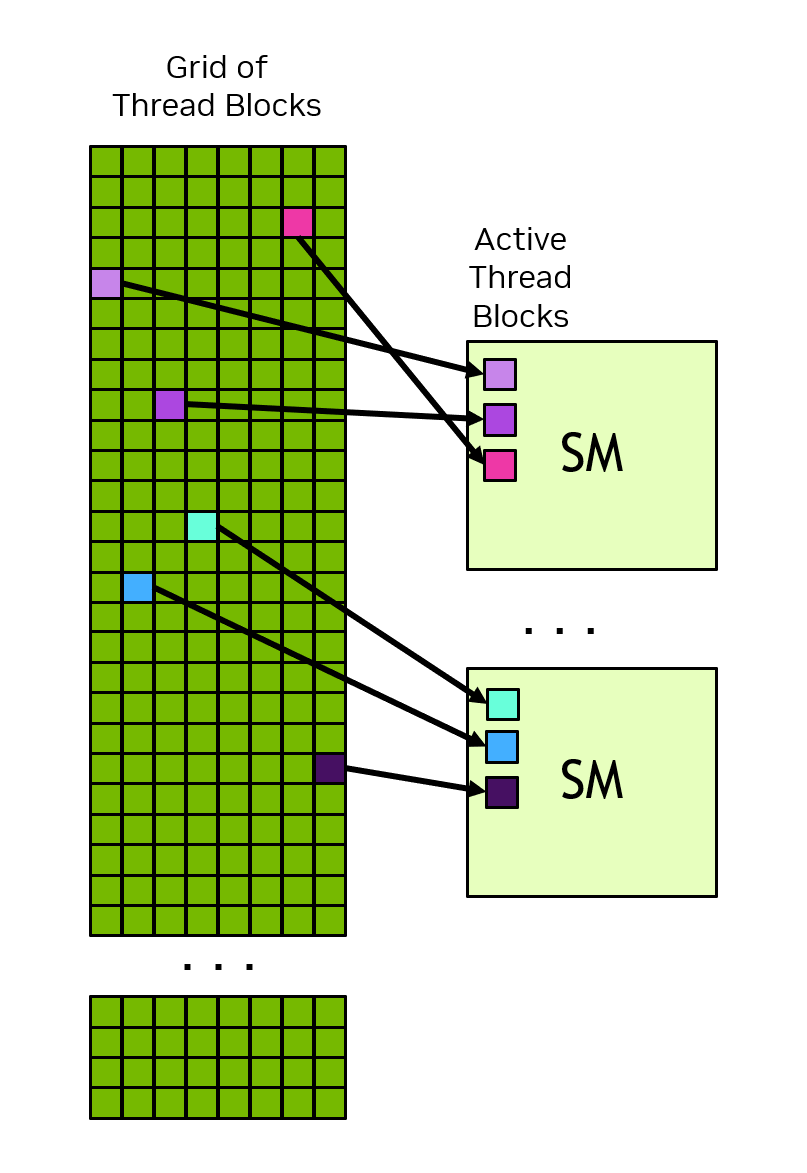
图4 每个SM都有一个或多个活动线程块。在此示例中,每个SM同时调度三个线程块。无法保证网格中的线程块被分配给SM的顺序。
这带来了 CUDA Programming Model 中一个非常重要的原则:不同 Thread Blocks 默认必须能够彼此独立地执行。
一个 Block 通常不能依赖另一个 Block 的结果,也不能假设另外一个 Block 已经执行完成,因为不同 Blocks 可以按照任何顺序执行,甚至可能串行执行。正是这种 Block Independence,使同一个 CUDA Grid 可以自动扩展到只有少量 SM 或拥有大量 SM 的不同 GPU 上。
1.2.2.1.1 Thread Block Clusters
从 Compute Capability 9.0 开始,CUDA 在 Thread Block 和 Grid 之间又提供了一层可选的组织结构:
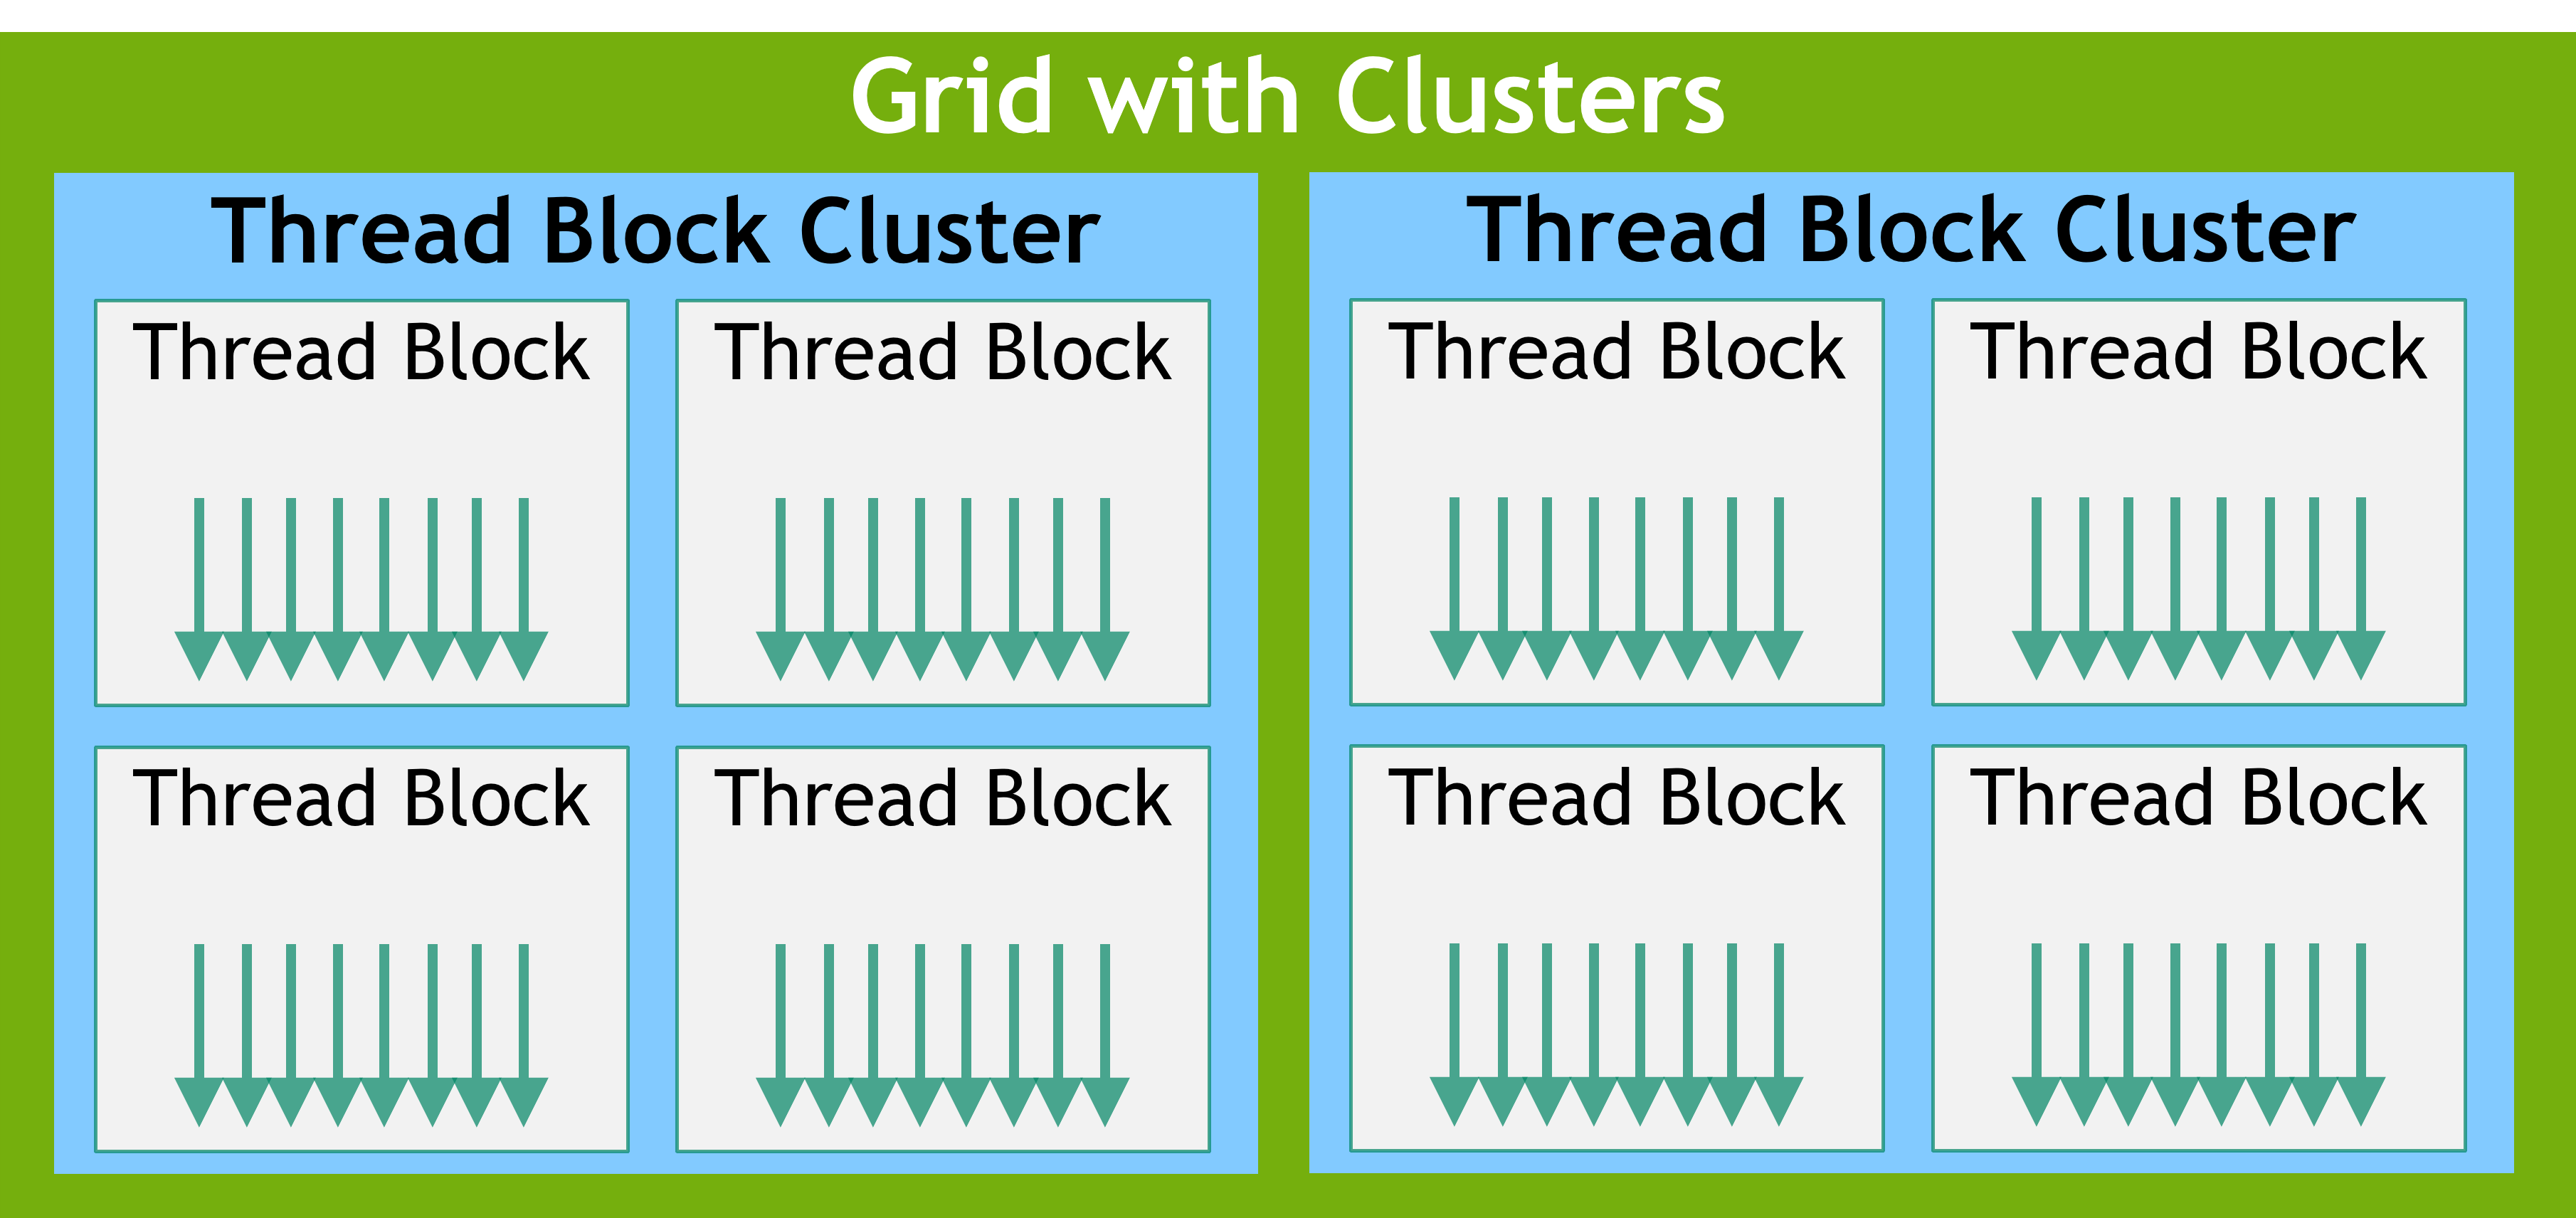
一个 Thread Block Cluster 由多个 Thread Blocks 组成,同样可以按照 1D、2D 或 3D 方式组织。指定 Cluster 并不会改变原来的 Grid 大小或者 Block 在 Grid 中的位置,而是在原有 Block 组织结构之上增加 Cluster 分组。
同一个 Cluster 中的 Thread Blocks 会被调度到同一个 GPC 中并同时执行,因此不同 Blocks 之间可以获得比普通 Block 更强的通信和同步能力。通过 Cooperative Groups 等接口,同一 Cluster 内不同 Blocks 的 Threads 可以进行同步,并访问 Cluster 内其他 Block 的 Shared Memory,这种机制称为 Distributed Shared Memory(DSM)。Cluster 能包含多少 Blocks 取决于具体 GPU 硬件。
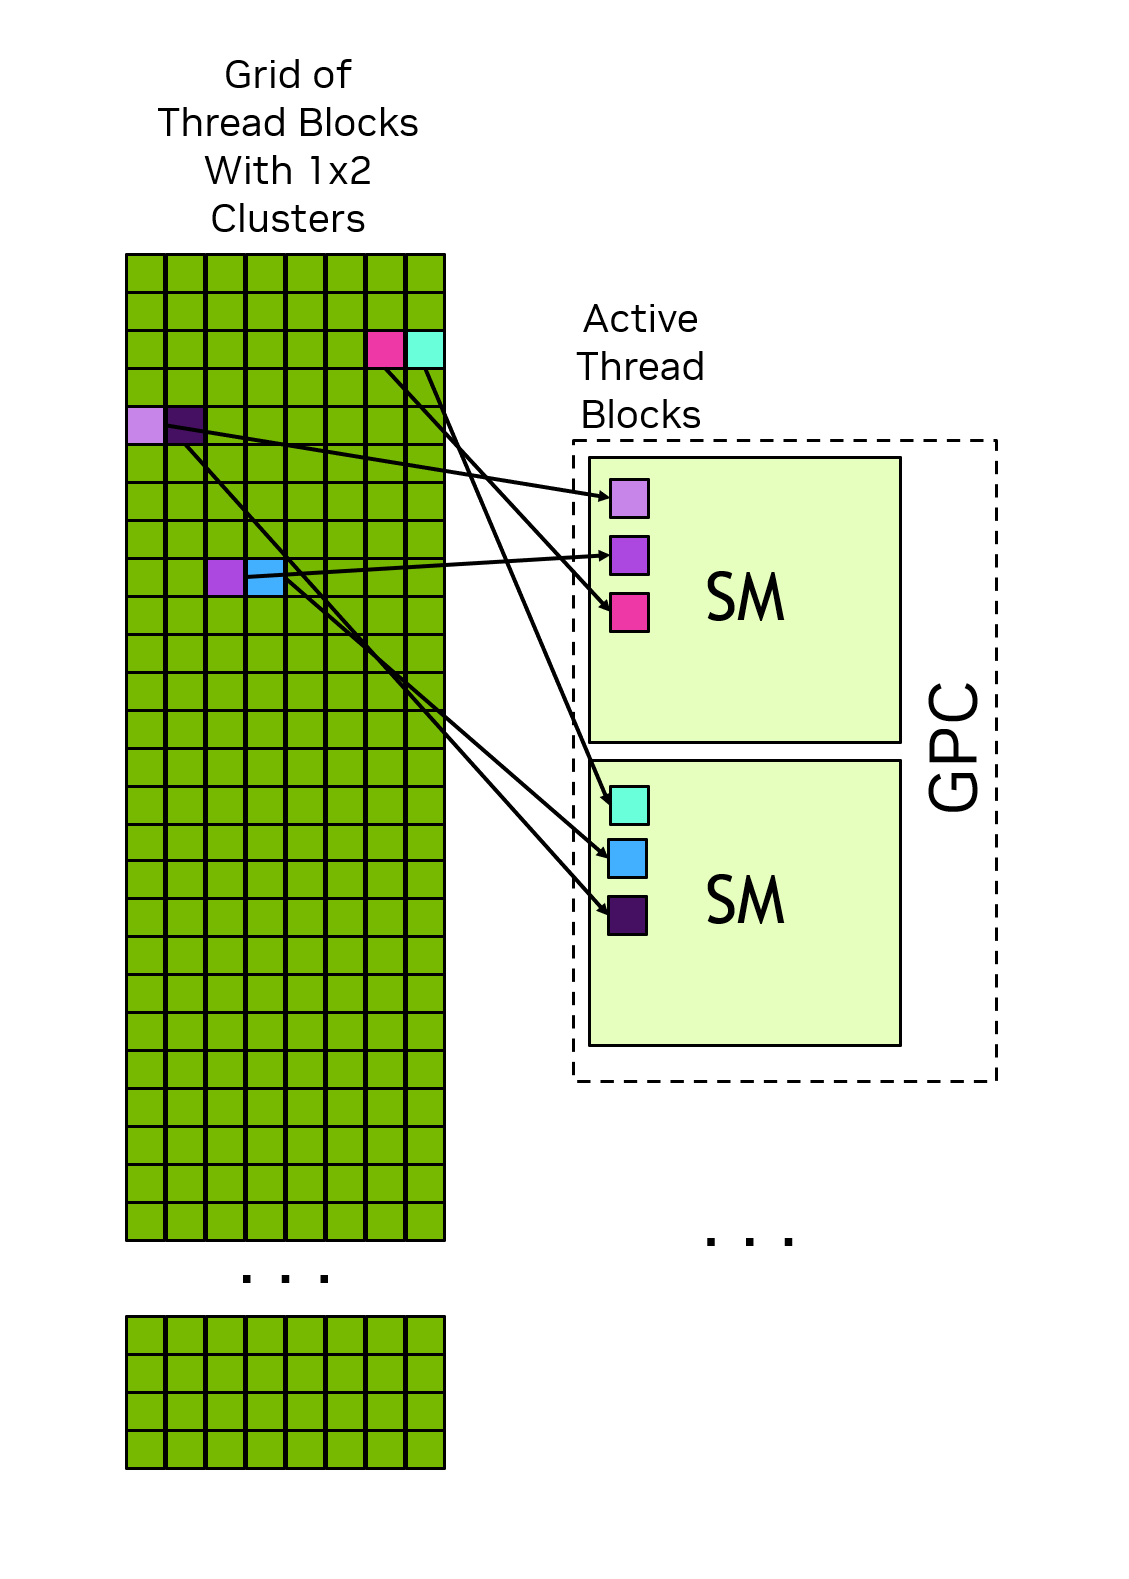
图6 指定线程块集群时,集群中的线程块会按照其集群形状排列在网格中。一个集群的线程块会在单个 GPC 的 SM 上同时进行调度。
1.2.2.2 Warps and SIMT
Thread Block 内部的 Threads 在硬件执行时进一步被组织成大小为 32 Threads 的组,这个组称为 Warp。
Thread Block
│
├── Warp 0 → 32 Threads
├── Warp 1 → 32 Threads
├── Warp 2 → 32 Threads
└── ...
Warp 是 GPU 执行 Threads 时非常重要的基本组织单位。一个 Warp 中的 32 个 Threads 按照 SIMT(Single-Instruction Multiple-Threads) 模型执行,每个 Thread 对应一个 Warp Lane,Lane 编号为 0~31。
在 SIMT 模型中,一个 Warp 中的 Threads 执行相同 Kernel,但每个 Thread 仍然拥有自己的状态,并允许经过不同的 Control Flow。例如遇到:
if (condition) {
    // ...
}
如果 Warp 中只有一部分 Threads 满足条件,满足条件的 Threads 会执行该分支,而其他 Threads 会暂时被 Masked Off。如果不同 Threads 选择了不同执行路径,这种情况称为 Warp Divergence。
Warp = 32 Threads

if (threadIdx.x % 2 == 0)

Lane 0   → Active
Lane 1   → Masked
Lane 2   → Active
Lane 3   → Masked
...
因此,同一个 Warp 内的 Threads 尽量执行相同 Control Flow,通常能够获得更好的硬件利用率。
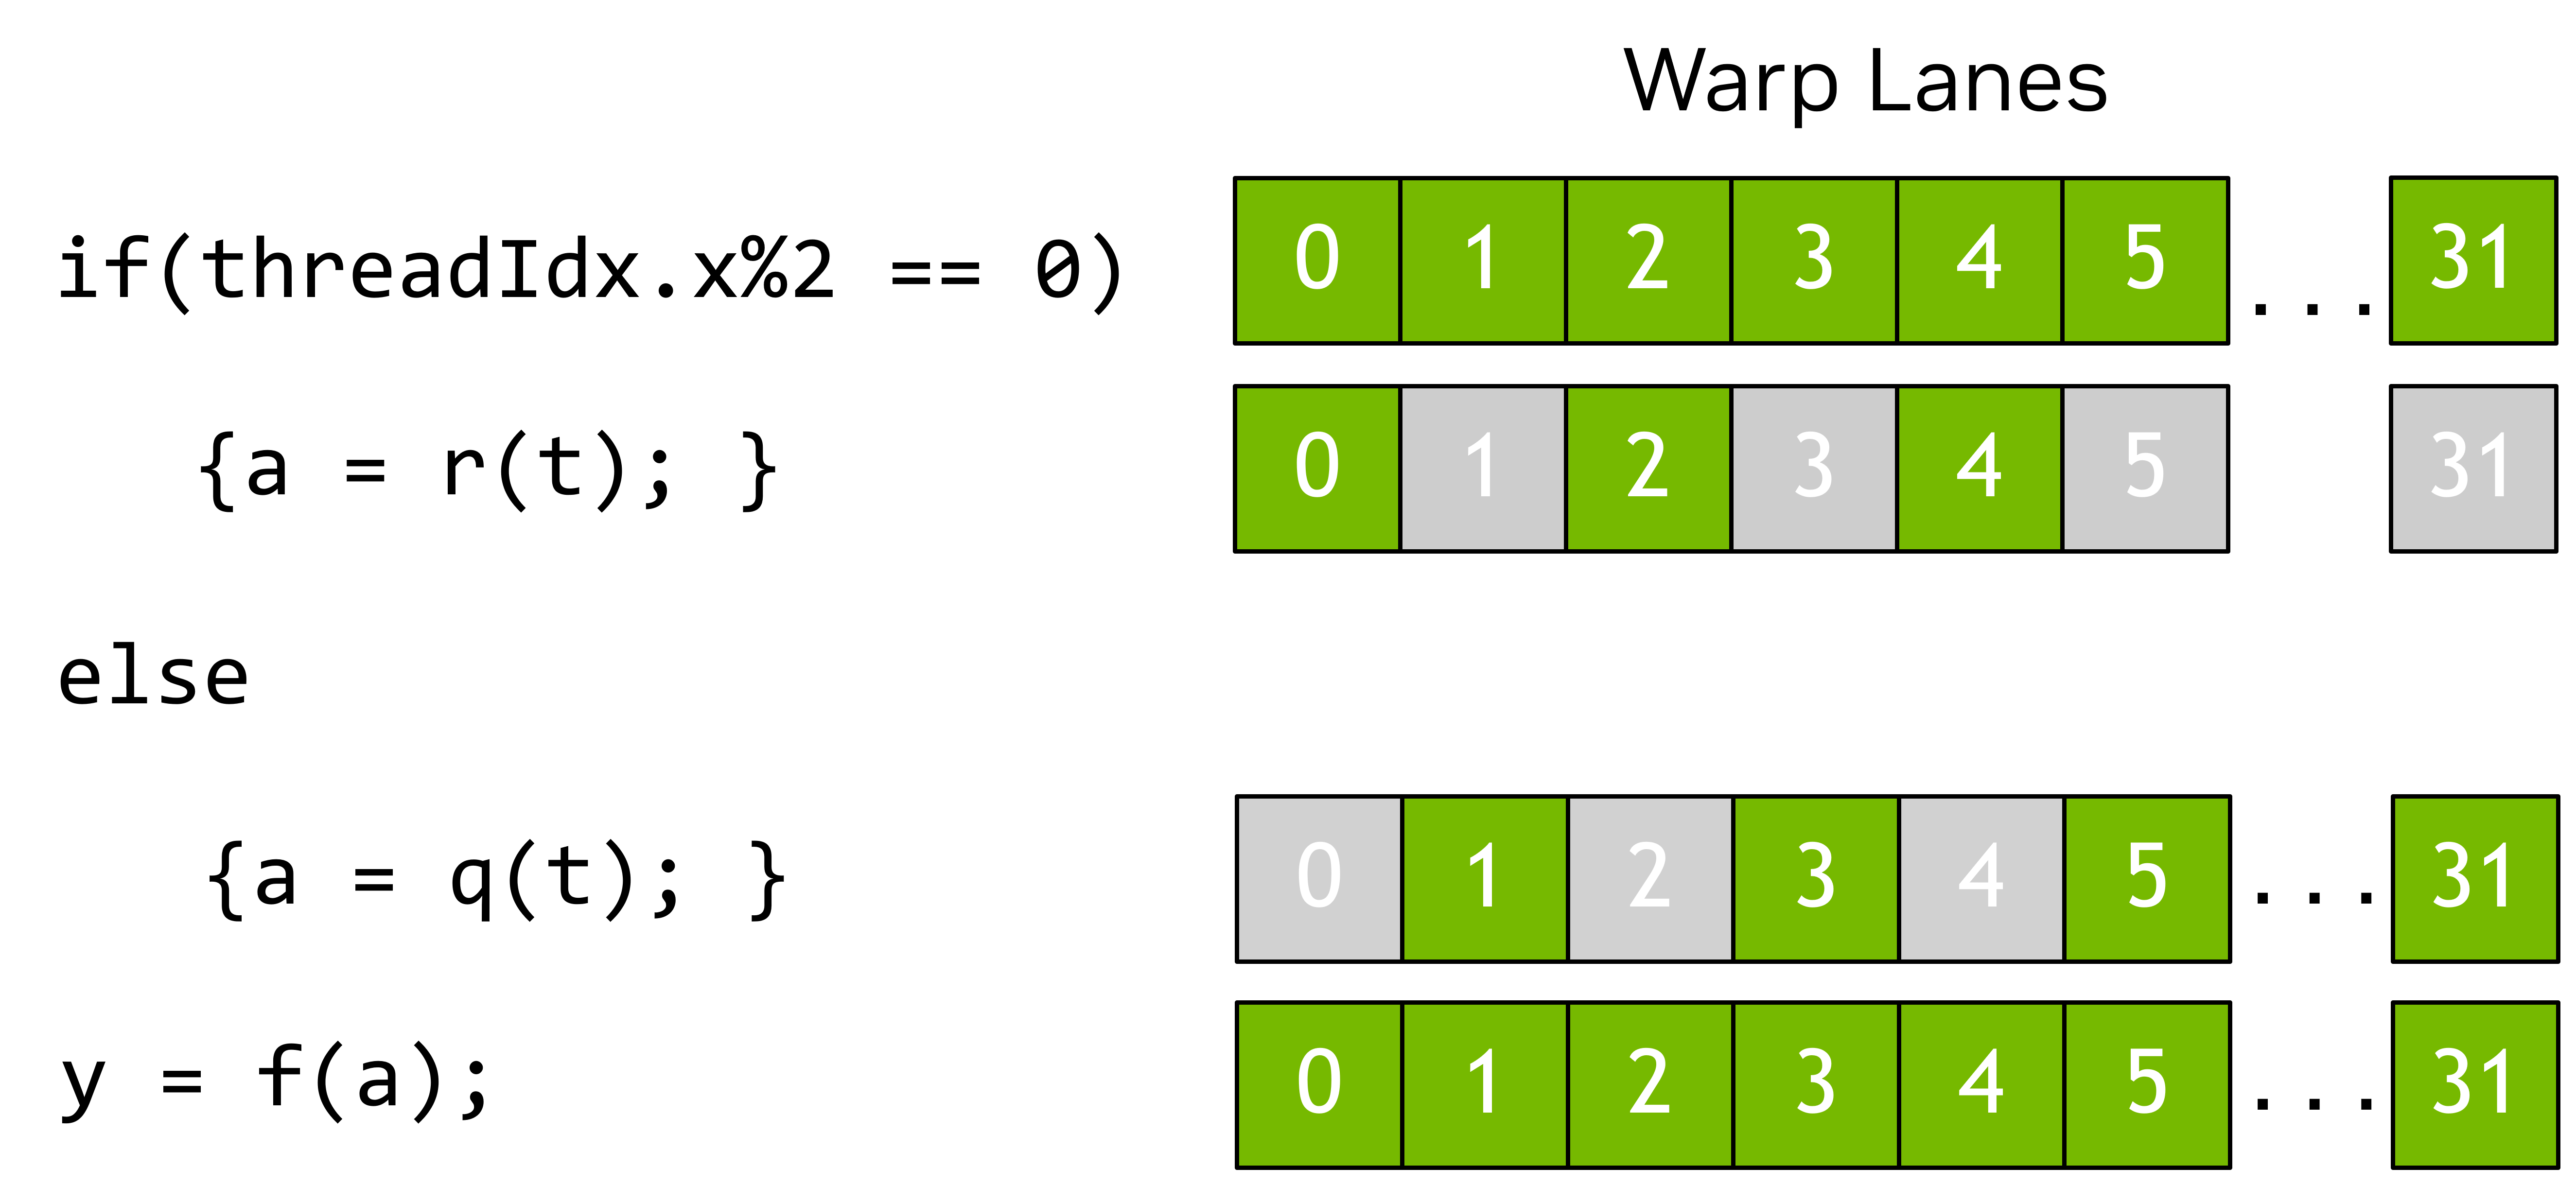
图7 在此示例中,只有线程索引为偶数的线程执行 if 语句的主体,执行该主体时,其余线程被屏蔽。
虽然编写基本 CUDA 程序时不一定需要直接操作 Warp,但理解 Warp 对性能优化非常重要,因为后面的 Global Memory Coalescing、Shared Memory Bank Access、Warp Specialization 等机制都与 Warp 的执行方式密切相关。
因此,一个 Thread Block 的 Thread 数量通常最好设置成 32 的倍数。如果不是 32 的倍数,最后一个 Warp 中会存在无法使用的 Lanes,从而降低计算和内存访问效率。
SIMT 与传统 SIMD(Single Instruction Multiple Data) 类似但并不相同。SIMD 中所有数据元素严格沿同一个 Control Flow 执行,而 SIMT 中每个 Thread 拥有自己的执行状态并允许拥有独立的 Control Flow,因此 SIMT 不具有 SIMD 那样固定的数据宽度。
1.2.2.3 Tile Programming in CUDA
除了传统的 SIMT Programming Model,CUDA 还支持 Tile Programming Model。
在 SIMT 中,程序员主要站在 Thread 的角度编写代码:
Thread 0 → Data 0
Thread 1 → Data 1
Thread 2 → Data 2
...
而在 Tile Programming 中,程序员站在整个 Thread Block 的角度编写代码,并直接描述如何处理称为 Tile 的多维数据集合,具体如何把这些运算分配给 Block 中的 Threads 则由 Compiler 完成。
Tile Kernel 与 SIMT Kernel 一样运行在由 Blocks 构成的 Grid 上,但程序员只需要指定 Grid Dimensions,而每个 Block 需要多少 Threads 会由 Compiler 根据 Tile Operations 自动决定。Tile Kernel 中整个 Block 只有一条 Control Flow,因此不存在传统 SIMT 中的 Warp Divergence 概念。
需要注意:Block 是 Execution Unit,而 Tile 是 Data Unit。 一个 Block 可以创建并处理多个不同 Shape 和 Data Type 的 Tiles。
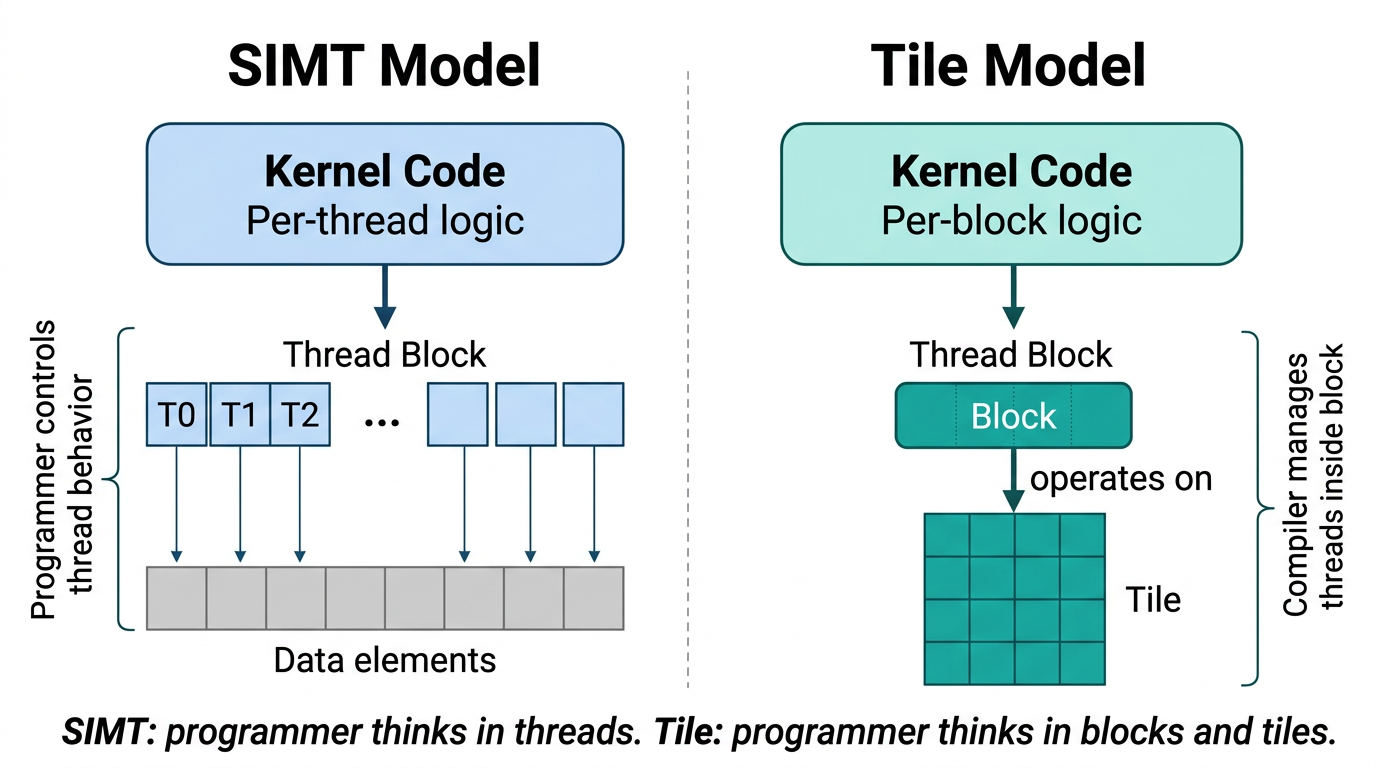
图8:SIMT 和分块编程模型中的程序员视角。在 SIMT 中,程序员编写每线程代码,并控制每个线程如何访问数据。在分块编程中,程序员编写对数据块进行操作的每块代码;编译器将操作映射到该块中的线程。
1.2.2.3.1 Arrays and Tiles
Tile Kernel 主要处理两种数据:Array 和 Tile。
Array 是存放在 Device Memory 中的多维数据容器,具有 Shape 和 Data Type,并且可以通过 Store 修改,因此是 Mutable 的。
Tile 则是只存在于 Tile Code 中、属于单个 Block 的多维数据集合。Tile 是 Immutable 的,对一个 Tile 执行操作会产生新的 Tile,而不是修改原来的 Tile。Tile 也不一定真正对应某块固定的 Memory,Compiler 可以根据情况将 Tile 数据放在 Registers、Shared Memory 或其他 SM 资源中。
Tile 的每个维度必须是 2 的幂并且在 Compile Time 已知,而且 Tile 不能作为 Kernel Parameter 直接传入,只能在 Tile Code 内创建和使用。
1.2.2.3.2 Tile Space and Data Movement
Array 和 Tile 之间的数据通过 Load 和 Store 移动。
CUDA 可以把一个 Array 概念上划分成大小相同且互不重叠的 Tiles,这个划分后的坐标空间称为 Tile Space。通过 Tile Space 中的坐标 (i, j) 可以确定从 Array 的哪个区域 Load 一个 Tile。
如果 Array 边界不能被 Tile Shape 整除,位于边界的 Tile 可能超出 Array 范围,Load 时可以指定如何处理这些越界元素,例如用 0 填充;Store 时落在 Array 边界之外的数据则会被直接忽略。Tile Programming 同时支持 Gather 和 Scatter,从而访问 Array 中任意位置的数据。
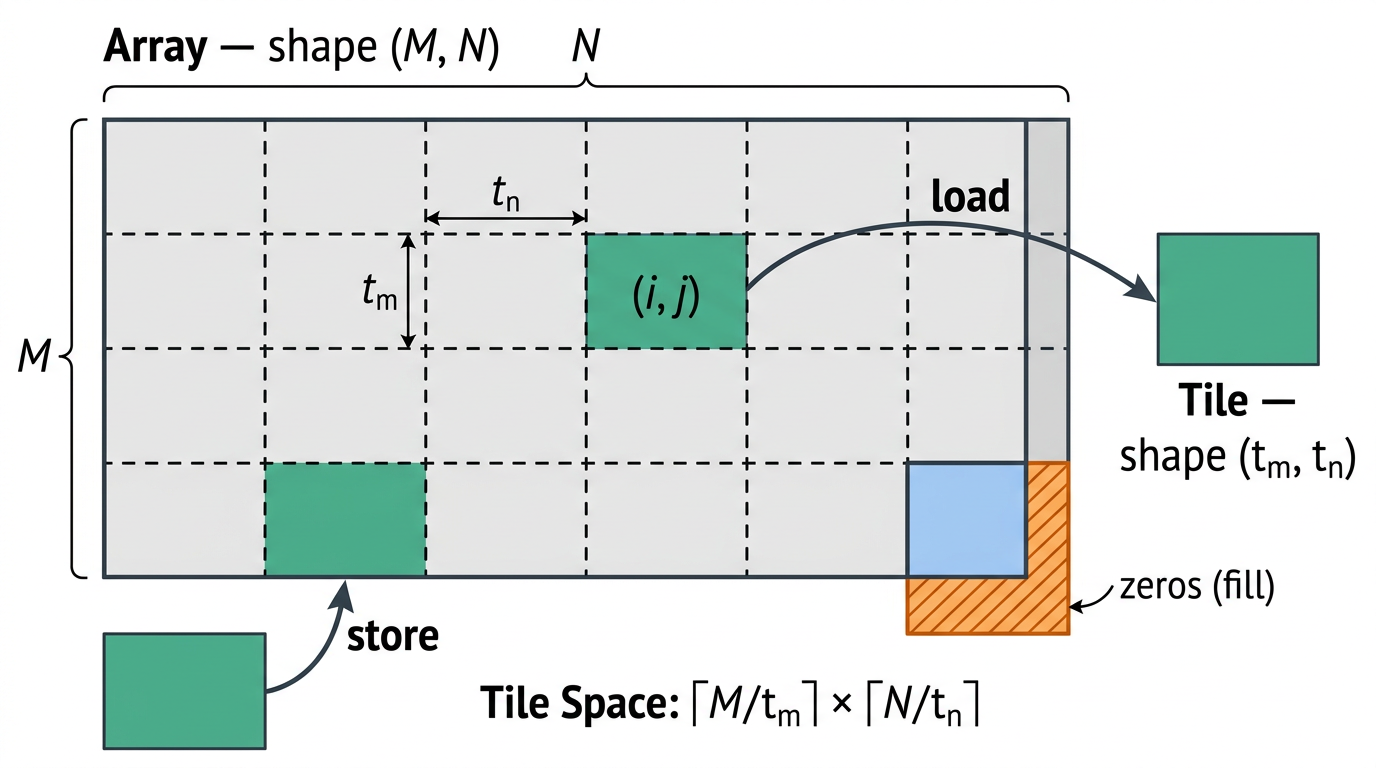
图9 Tile space与数据移动。形状为 (M, N) 的二维数组在概念上被划分为由形状为 (tm, tn) 的Tile组成的网格。位于Tile space索引 (i, j) 处的加载操作会返回相应的图块。在数组边界处,超出数组范围的元素可以用零填充。存储操作会将一个Tile写回数组中给定Tile Space索引处的位置。
1.2.2.3.3 Operations on Tiles
CUDA 提供了大量直接作用于 Tile 的内置操作,包括:
Elementwise Arithmetic
Matrix Multiplication
Reduction
Reshape / Transpose
Type Conversion
当不同 Shape 的 Tiles 参与某些运算时,较小的 Tile 可以自动扩展到与较大的 Tile 匹配,然后执行相应操作。
1.2.2.3.4 Relationship to SIMT Programming
Tile Programming 并不会替代传统的 SIMT Programming。一个 CUDA Application 可以同时包含 SIMT Kernels 和 Tile Kernels,而且二者可以操作相同的 Device Memory,程序员可以针对不同 Kernel 选择不同 Programming Model。
SIMT 提供更加细粒度的 Thread-Level Control,适合需要显式控制 Threads 或进行底层性能优化的算法;Tile Programming 则提供更高层的抽象,把线程映射等细节交给 Compiler,因此同一个 Tile Kernel 更容易适配不同 GPU 架构。两种模型底层最终仍然建立在相同的 SM、Thread Block、Grid 和 Device Memory 之上。
1.2.3 GPU Memory
GPU Programming 不仅需要充分使用计算单元,还需要高效使用 Memory。异构系统中存在多个 Memory Spaces,而 GPU 内部除了 Device DRAM,还包含 Registers、Shared Memory 和 Cache 等多种存储资源,因此理解 GPU Memory Hierarchy 是 CUDA Programming Model 的另一个核心部分。
1.2.3.1 DRAM Memory in Heterogeneous Systems
CPU 和 GPU 都有各自直接连接的 DRAM。GPU 直接连接的 DRAM 从 Device Code 的角度称为 Global Memory,因为 GPU 中所有 SM 都可以访问它;CPU 直接连接的 DRAM 则称为 System Memory 或 Host Memory。在 Multi-GPU 系统中,每块 GPU 通常拥有自己的 Global Memory。
现代 CUDA 系统中的 CPU 和 GPU 使用 Unified Virtual Address Space。CPU、不同 GPU 的内存虽然在物理位置上可能不同,但它们的 Virtual Address 都位于一个统一地址空间中,而且不同设备对应的 Virtual Address Range 彼此不同,因此可以根据一个地址判断它属于 CPU Memory 还是某块 GPU Memory。
CUDA 提供 API 用于:
Allocate CPU Memory
Allocate GPU Memory

CPU → GPU Copy
GPU → CPU Copy
GPU → GPU Copy
程序员可以显式控制 Data Locality,也可以通过后面介绍的 Unified Memory 让 CUDA Runtime 或系统硬件自动处理数据放置。
1.2.3.2 On-Chip Memory in GPUs
除了 Global Memory,每个 SM 内部还拥有速度非常快的 On-Chip Memory,其中最重要的是:
Registers
Shared Memory
Registers 主要保存单个 Thread 的 Local Variables,一般由 Compiler 自动分配;Shared Memory 则由一个 Thread Block 或 Cluster 中的 Threads 共同访问,因此非常适合在 Threads 之间交换数据。
这些 On-Chip Resources 数量有限。一个 SM 能同时运行多少 Thread Blocks,会受到 Register 和 Shared Memory 使用量的约束。例如,一个 Block 所有 Threads 所需要的 Registers 总量必须能够放入 SM 的 Register File 中;Shared Memory 则以 Thread Block 为单位进行分配。
因此后面进行 CUDA Performance Optimization 时,经常会出现:
Registers per Thread
        +
Threads per Block
        +
Shared Memory per Block
        ↓
SM Resource Usage
        ↓
Number of Active Blocks / Warps
        ↓
Occupancy
1.2.3.2.1 Caches
GPU 同样拥有 Cache Hierarchy。每个 SM 都拥有自己的 L1 Cache,它与 Shared Memory 共享 Unified Data Cache 的硬件资源;整个 GPU 还有一个由所有 SM 共享的更大的 L2 Cache。
此外,每个 SM 还有独立的 Constant Cache,用于缓存 Kernel 生命周期内保持不变的 Constant Memory 数据,Compiler 也可能把 Kernel Parameters 放入 Constant Memory,从而避免占用普通 L1 Data Cache。
可以把这一层 Memory Hierarchy 暂时理解为:
Thread
  ↓
Registers
  ↓
Shared Memory / L1 Cache
  ↓
L2 Cache
  ↓
Global Memory
这里越靠上通常容量越小、距离执行单元越近;越靠下容量越大。具体性能特征和访问规则会在后面的章节进一步展开。
1.2.3.3 Unified Memory
如果程序分别在 CPU 和 GPU 上显式分配普通 Memory,那么这些内存默认只能直接由对应设备上的代码访问,因此传统 CUDA 程序需要使用 Memory Copy API,在 CPU 和 GPU 之间显式搬运数据。
Unified Memory 提供了一种更高层的方式:应用可以创建同时能够被 CPU 和 GPU 访问的 Memory Allocation,具体数据应该位于 CPU Memory 还是 GPU Memory,可以由 CUDA Runtime 或底层 Hardware 根据访问情况进行迁移和管理。
不过 Unified Memory 并不意味着 Data Locality 不再重要。为了获得最佳性能,仍然应该尽量减少数据在 CPU 和 GPU 之间的迁移,并让处理器尽可能访问与自己直接连接的 Memory。不同系统具体如何实现 Unified Memory,取决于其 Hardware Features,后面的 Unified Memory 专门章节会进一步介绍。