2.1 Intro to CUDA C++
本章通过说明 CUDA 编程模型中的一些基本概念如何在 C++ 中体现,介绍 CUDA 编程的基础内容。
本 Programming Guide 主要关注 CUDA Runtime API。CUDA Runtime API 是在 C++ 中使用 CUDA 最常见的方式,并且构建在更底层的 CUDA Driver API 之上。
CUDA Runtime API and CUDA Driver API 讨论了这两套 API 的区别;CUDA Driver API 则介绍如何编写混合使用两套 API 的代码。
本指南假定已经安装 CUDA Toolkit 和 NVIDIA Driver,并且系统中存在受支持的 NVIDIA GPU。安装所需 CUDA 组件的说明参见 The CUDA Quickstart Guide。
2.1.1 Compilation with NVCC
用 C++ 编写的 GPU 代码使用 NVIDIA CUDA Compiler nvcc 编译。nvcc 是一个 compiler driver,用于简化 C++ 或 PTX 代码的编译过程:它提供简单、常见的命令行选项,并通过调用实现各个编译阶段的一系列工具来完成编译。
本指南后续给出的 nvcc 命令行可以用于:安装了 CUDA Toolkit 的 Linux 系统、Windows Command Prompt 或 PowerShell,以及安装了 CUDA Toolkit 的 Windows Subsystem for Linux(WSL)。本指南的 nvcc chapter 介绍 nvcc 的常见使用方式;完整文档参见 nvcc user manual。
2.1.2 Kernels
如 CUDA Programming Model 中所述,在 GPU 上执行、并可由 host 调用的函数称为 Kernel。Kernel 被设计为由大量并行 Thread 同时执行。([NVIDIA Docs][1])
2.1.2.1 Specifying Kernels
Kernel 代码使用 __global__ declaration specifier 声明。它告诉编译器:该函数需要被编译为 GPU 代码,并能够通过 kernel launch 启动。Kernel launch 是启动一个 Kernel 执行的操作,通常由 CPU 发起。Kernel 函数的返回类型必须为 void。
// Kernel definition
__global__ void vecAdd(float* A, float* B, float* C)
{

}
2.1.2.2 Launching Kernels
并行执行 Kernel 的 Thread 数量在 kernel launch 时指定,这组参数称为 execution configuration。同一个 Kernel 的不同调用可以使用不同的 execution configuration,例如不同数量的 Thread 或 Thread Block。
CPU 代码启动 Kernel 有两种方式:triple chevron notation 和 cudaLaunchKernelEx。其中 triple chevron notation 是最常用的方法,本节首先介绍它;使用 cudaLaunchKernelEx 的示例及详细讨论见 Section 3.1.1。([NVIDIA Docs][1])
2.1.2.2.1 Triple Chevron Notation
Triple chevron notation 是一种 CUDA C++ Language Extension,用于启动 Kernel。之所以称为 triple chevron,是因为使用 <<< >>> 包围 kernel launch 的 execution configuration。配置参数像普通函数参数一样,以逗号分隔:
__global__ void vecAdd(float* A, float* B, float* C)
{

}

int main()
{
    ...
    // Kernel invocation
    vecAdd<<<1, 256>>>(A, B, C);
    ...
}
<<< >>> 中前两个参数依次表示 Grid dimensions 和 Thread Block dimensions。对于一维 Grid 或 Thread Block,可以直接使用整数。上例启动 1 个 Thread Block,每个 Block 包含 256 个 Thread;所有 Thread 执行完全相同的 Kernel 代码,之后会介绍如何利用 Thread 在 Block 和 Grid 中的索引,让不同 Thread 操作不同的数据。
每个 Block 的 Thread 数量存在上限,因为同一 Block 中的所有 Thread 都驻留在同一个 SM(Streaming Multiprocessor) 上,并共享该 SM 的资源。当前 GPU 上,一个 Thread Block 最多可包含 1024 个 Thread;如果资源允许,一个 SM 可以同时调度多个 Thread Block。
Kernel launch 相对于 host thread 是异步(asynchronous) 的:Kernel 会被提交到 GPU 执行,但 host 代码不会等待 Kernel 完成,甚至不会等待 Kernel 真正开始执行,就会继续向下运行。因此需要某种 GPU/CPU synchronization 才能确定 Kernel 已完成。最基本的全 GPU synchronization 会在后面的 Synchronizing CPU and GPU 中介绍,更复杂的同步方法见 Asynchronous Execution。
对于二维或三维 Grid / Thread Block,使用 CUDA 类型 dim3 指定维度。例如下面启动一个 16×16 个 Block 的 Grid,每个 Block 为 8×8 个 Thread:
int main()
{
    ...
    dim3 grid(16,16);
    dim3 block(8,8);
    MatAdd<<<grid, block>>>(A, B, C);
    ...
}
2.1.2.3 Thread and Grid Index Intrinsics
在 Kernel 代码内部,CUDA 提供了一组 intrinsic,用于访问 execution configuration 以及当前 Thread / Block 的索引:
threadIdx:当前 Thread 在其 Thread Block 内的索引,每个 Thread 不同。blockDim:Thread Block 的维度,由 kernel launch 的 execution configuration 指定。blockIdx:当前 Thread Block 在 Grid 中的索引,每个 Block 不同。gridDim:Grid 的维度,由 kernel launch 的 execution configuration 指定。
这些 intrinsic 都是包含 .x、.y、.z 三个成员的三维向量。launch configuration 中未指定的维度默认值为 1。threadIdx 和 blockIdx 都从 0 开始,例如:
threadIdx.x = 0 ... blockDim.x - 1
blockIdx.x  = 0 ... gridDim.x  - 1
.y 和 .z 维度遵循相同规则。
这些索引使每个 Thread 能够确定自己应该执行哪部分工作。回到 vecAdd:Kernel 接收三个 float vector,对 A 和 B 做逐元素加法并写入 C。每个 Thread 负责一次加法,其处理的元素由 Thread 和 Block 索引决定:
__global__ void vecAdd(float* A, float* B, float* C)
{
   // calculate which element this thread is responsible for computing
   int workIndex = threadIdx.x + blockDim.x * blockIdx.x

   // Perform computation
   C[workIndex] = A[workIndex] + B[workIndex];
}

int main()
{
    ...
    // A, B, and C are vectors of 1024 elements
    vecAdd<<<4, 256>>>(A, B, C);
    ...
}
这里使用 4 个 Block × 256 个 Thread = 1024 个 Thread 处理 1024 个元素。第一个 Block 中 blockIdx.x = 0,所以 workIndex = threadIdx.x;第二个 Block 中 blockIdx.x = 1,因此 workIndex = threadIdx.x + 256;第三个 Block 则为 threadIdx.x + 512。这种
threadIdx.x + blockDim.x * blockIdx.x
形式是一维并行化中非常常见的全局 Thread 索引计算方式;扩展到二维或三维时通常在各个维度采用类似模式。
2.1.2.3.1 Bounds Checking
上面的例子假设 vector 长度正好是 Thread Block 大小(这里为 256)的整数倍。为了处理任意长度,需要检查访问是否超过数组边界:
__global__ void vecAdd(float* A, float* B, float* C, int vectorLength)
{
     // calculate which element this thread is responsible for computing
     int workIndex = threadIdx.x + blockDim.x * blockIdx.x

     if(workIndex < vectorLength)
     {
         // Perform computation
         C[workIndex] = A[workIndex] + B[workIndex];
     }
}
这样可以启动比实际需要更多的 Thread,而不会发生越界访问。当 workIndex >= vectorLength 时,这些 Thread 不执行实际工作。在一个 Block 中包含少量不工作的额外 Thread 通常开销不大,但应避免启动整个 Block 却没有任何 Thread 执行有效工作。
需要的 Block 数量等于:
常见的整数写法为:
// vectorLength is an integer storing number of elements in the vector
int threads = 256;
int blocks = (vectorLength + threads-1)/threads;
vecAdd<<<blocks, threads>>>(devA, devB, devC, vectorLength);
在整数除法前加 threads - 1,可以实现向上取整:只有当 vectorLength 不能被 threads 整除时,才额外增加一个 Block。
CUDA Core Compute Libraries (CCCL) 也提供了 cuda::ceil_div 来完成这种 ceiling division,包含头文件 <cuda/cmath> 即可使用:
// vectorLength is an integer storing number of elements in the vector
int threads = 256;
int blocks = cuda::ceil_div(vectorLength, threads);
vecAdd<<<blocks, threads>>>(devA, devB, devC, vectorLength);
这里选择 256 threads per block 并非硬性要求,但通常是一个不错的起始值。
2.1.3 Memory in GPU Computing
为了使用前面介绍的 vecAdd Kernel,数组 A、B 和 C 必须位于 GPU 能够访问的内存中。实现这一点有多种方式,本节介绍其中两种;其他方式会在后面的 Unified Memory 章节继续介绍。GPU 代码可使用的 memory space 已在 GPU Memory 中初步介绍,并会在 GPU Device Memory Spaces 中详细讨论。
2.1.3.1 Unified Memory
Unified Memory 是 CUDA Runtime 提供的一项功能,它允许 NVIDIA Driver 管理数据在 host 与 device(s) 之间的移动。可以使用 cudaMallocManaged API 分配这类内存,也可以使用 __managed__ specifier 声明变量。当 CPU 或 GPU 访问这些数据时,NVIDIA Driver 会确保相应内存可被访问。
下面给出了使用 Unified Memory 启动 vecAdd Kernel 的完整函数。cudaMallocManaged 分配的 buffer 可以同时被 CPU 和 GPU 访问,并使用 cudaFree 释放:
void unifiedMemExample(int vectorLength)
{
    // Pointers to memory vectors
    float* A = nullptr;
    float* B = nullptr;
    float* C = nullptr;
    float* comparisonResult = (float*)malloc(vectorLength*sizeof(float));

    // Use unified memory to allocate buffers
    cudaMallocManaged(&A, vectorLength*sizeof(float));
    cudaMallocManaged(&B, vectorLength*sizeof(float));
    cudaMallocManaged(&C, vectorLength*sizeof(float));

    // Initialize vectors on the host
    initArray(A, vectorLength);
    initArray(B, vectorLength);

    // Launch the kernel. Unified memory will make sure A, B, and C are
    // accessible to the GPU
    int threads = 256;
    int blocks = cuda::ceil_div(vectorLength, threads);
    vecAdd<<<blocks, threads>>>(A, B, C, vectorLength);

    // Wait for the kernel to complete execution
    cudaDeviceSynchronize();

    // Perform computation serially on CPU for comparison
    serialVecAdd(A, B, comparisonResult, vectorLength);

    // Confirm that CPU and GPU got the same answer
    if(vectorApproximatelyEqual(C, comparisonResult, vectorLength))
    {
        printf("Unified Memory: CPU and GPU answers match\n");
    }
    else
    {
        printf("Unified Memory: Error - CPU and GPU answers do not match\n");
    }

    // Clean Up
    cudaFree(A);
    cudaFree(B);
    cudaFree(C);
    free(comparisonResult);
}
Unified Memory 支持 CUDA 所支持的所有操作系统和 GPU,但其底层实现机制和性能会随系统架构而不同。更多细节见 Unified Memory。在某些 Linux 系统中,例如支持 Address Translation Services(ATS) 或 Heterogeneous Memory Management(HMM) 的系统,所有 system memory 会自动作为 Unified Memory,因此无需专门使用 cudaMallocManaged 或 __managed__。
2.1.3.2 Explicit Memory Management
显式管理不同 memory space 中的内存分配和数据迁移可以帮助提升应用性能,但代码也会更加冗长。下面的代码使用 cudaMalloc 显式在 GPU 上分配内存;GPU 内存同样使用 cudaFree 释放。([NVIDIA Docs][1])
void explicitMemExample(int vectorLength)
{
    // Pointers for host memory
    float* A = nullptr;
    float* B = nullptr;
    float* C = nullptr;
    float* comparisonResult = (float*)malloc(vectorLength*sizeof(float));

    // Pointers for device memory
    float* devA = nullptr;
    float* devB = nullptr;
    float* devC = nullptr;

    // Allocate Host Memory using cudaMallocHost API. This is best practice
    // when buffers will be used for copies between CPU and GPU memory
    cudaMallocHost(&A, vectorLength*sizeof(float));
    cudaMallocHost(&B, vectorLength*sizeof(float));
    cudaMallocHost(&C, vectorLength*sizeof(float));

    // Initialize vectors on the host
    initArray(A, vectorLength);
    initArray(B, vectorLength);

    // Allocate memory on the GPU
    cudaMalloc(&devA, vectorLength*sizeof(float));
    cudaMalloc(&devB, vectorLength*sizeof(float));
    cudaMalloc(&devC, vectorLength*sizeof(float));

    // Copy data to the GPU
    cudaMemcpy(devA, A, vectorLength*sizeof(float), cudaMemcpyDefault);
    cudaMemcpy(devB, B, vectorLength*sizeof(float), cudaMemcpyDefault);
    cudaMemset(devC, 0, vectorLength*sizeof(float));

    // Launch the kernel
    int threads = 256;
    int blocks = cuda::ceil_div(vectorLength, threads);
    vecAdd<<<blocks, threads>>>(devA, devB, devC, vectorLength);

    // wait for kernel execution to complete
    cudaDeviceSynchronize();

    // Copy results back to host
    cudaMemcpy(C, devC, vectorLength*sizeof(float), cudaMemcpyDefault);

    // Perform computation serially on CPU for comparison
    serialVecAdd(A, B, comparisonResult, vectorLength);

    // Confirm that CPU and GPU got the same answer
    if(vectorApproximatelyEqual(C, comparisonResult, vectorLength))
    {
        printf("Explicit Memory: CPU and GPU answers match\n");
    }
    else
    {
        printf("Explicit Memory: Error - CPU and GPU answers to not match\n");
    }

    // clean up
    cudaFree(devA);
    cudaFree(devB);
    cudaFree(devC);
    cudaFreeHost(A);
    cudaFreeHost(B);
    cudaFreeHost(C);
    free(comparisonResult);
}
CUDA API cudaMemcpy 用于在不同位置的 buffer 之间复制数据。除了 destination pointer、source pointer 和字节数之外,最后一个参数是 cudaMemcpyKind_t,常见值包括:
cudaMemcpyHostToDevice:CPU → GPUcudaMemcpyDeviceToHost:GPU → CPUcudaMemcpyDeviceToDevice:同一 GPU 内部或 GPU → GPU
本例使用:
cudaMemcpyDefault
作为 cudaMemcpy 的最后一个参数,此时 CUDA 会根据 source 和 destination pointer 的值自动判断复制类型。
cudaMemcpy 是同步 API,也就是说,在数据复制完成之前该函数不会返回。异步 copy 会在 Launching Memory Transfers in CUDA Streams 中介绍。
代码还使用 cudaMallocHost 在 CPU 上分配内存。它分配的是 page-locked memory(页锁定内存),可以提高 CPU↔GPU copy 性能,并且对于 asynchronous memory transfer 是必需的。一般来说,需要与 GPU 进行数据传输的 CPU buffer 最好使用 page-locked memory;但在某些系统上,锁定过多 host memory 会导致性能下降,因此最佳实践是:只 page-lock 真正用于向 GPU 发送或从 GPU 接收数据的 buffer。
2.1.3.3 Memory Management and Application Performance
从上面的例子可以看到,Explicit Memory Management 代码更加冗长,因为程序员必须明确指定 host 和 device 之间的数据 copy。这既是它的缺点,也是它的优点:程序员可以更精确地控制何时复制数据、数据驻留在哪里、以及具体在哪个 memory space 中分配内存。通过控制 memory transfer,并让数据传输与其他计算发生 overlap,显式内存管理能够提供更多性能优化机会。
使用 Unified Memory 时,CUDA 也提供了一些 API(后续 Memory Advise and Prefetch 会介绍),用于向管理内存的 NVIDIA Driver 提供提示,从而在使用 Unified Memory 的同时获得一部分 Explicit Memory Management 所具有的性能优势。
2.1.4 Synchronizing CPU and GPU
如 Launching Kernels 中所述,Kernel launch 相对于发起调用的 CPU Thread 是异步的。这意味着在 Kernel 完成执行之前,甚至可能在 Kernel 真正开始执行之前,CPU Thread 的控制流就会继续向下执行。因此,如果 host 代码在继续执行前必须保证某个 Kernel 已完成,就需要使用同步机制。
最简单的 GPU 与 host Thread 同步方法是:
cudaDeviceSynchronize();
cudaDeviceSynchronize() 会阻塞 host Thread,直到此前提交到 GPU 的所有工作都完成。本章示例中 GPU 每次只执行单个操作,因此这种方式已经足够。但在更大的应用中,GPU 上可能有多个 streams 同时执行任务,而 cudaDeviceSynchronize() 会等待所有 Stream 中的工作全部完成。
对于这类应用,推荐使用 Stream Synchronization API,只与特定 Stream 同步,或者使用 CUDA Events。这些机制会在 Asynchronous Execution 一章中详细介绍。
2.1.5 Putting it All Together
下面把本章前面介绍的内容组合起来,给出完整的 vector addition 示例,包括 Kernel、host 端代码以及用于检查计算结果是否正确的辅助函数。示例默认 vector 长度为 1024,也可以通过程序的命令行参数指定其他长度。
Unified Memory
整体结构如下,核心流程依次是:定义 vecAdd Kernel → 初始化输入 → CPU 串行计算用于校验 → cudaMallocManaged 分配 Unified Memory → launch Kernel → cudaDeviceSynchronize() → 校验结果 → 释放内存。
#include <cuda_runtime_api.h>
#include <cstdlib>
#include <ctime>
#include <cstdio>
#include <cmath>
#include <cuda/cmath>

__global__ void vecAdd(float* A, float* B, float* C, int vectorLength)
{
    int workIndex = threadIdx.x + blockIdx.x * blockDim.x;

    if (workIndex < vectorLength)
        C[workIndex] = A[workIndex] + B[workIndex];
}

void initArray(float* A, int length)
{
    for (int i = 0; i < length; ++i)
        A[i] = rand() / (float)RAND_MAX;
}

void serialVecAdd(float* A, float* B, float* C, int length)
{
    for (int i = 0; i < length; ++i)
        C[i] = A[i] + B[i];
}

bool vectorApproximatelyEqual(
    float* A, float* B, int length,
    float epsilon = 0.00001f)
{
    for (int i = 0; i < length; ++i) {
        if (fabs(A[i] - B[i]) > epsilon)
            return false;
    }
    return true;
}
Unified Memory 部分:
void unifiedMemExample(int vectorLength)
{
    float *A = nullptr, *B = nullptr, *C = nullptr;

    float* comparisonResult =
        (float*)malloc(vectorLength * sizeof(float));

    cudaMallocManaged(&A, vectorLength * sizeof(float));
    cudaMallocManaged(&B, vectorLength * sizeof(float));
    cudaMallocManaged(&C, vectorLength * sizeof(float));

    initArray(A, vectorLength);
    initArray(B, vectorLength);

    int threads = 256;
    int blocks = cuda::ceil_div(vectorLength, threads);

    vecAdd<<<blocks, threads>>>(A, B, C, vectorLength);

    cudaDeviceSynchronize();

    serialVecAdd(A, B, comparisonResult, vectorLength);

    if (vectorApproximatelyEqual(C, comparisonResult, vectorLength))
        printf("Unified Memory: CPU and GPU answers match\n");
    else
        printf("Unified Memory: Error\n");

    cudaFree(A);
    cudaFree(B);
    cudaFree(C);
    free(comparisonResult);
}
main() 默认使用 1024 个元素;如果提供命令行参数,则将该参数转换为 vector 长度:
int main(int argc, char** argv)
{
    int vectorLength = 1024;

    if (argc >= 2)
        vectorLength = std::atoi(argv[1]);

    unifiedMemExample(vectorLength);
    return 0;
}
Explicit Memory Management
显式内存版本使用相同的 Kernel 和校验辅助函数,但 CPU 和 GPU 使用独立的 buffer。Host buffer 使用 cudaMallocHost 分配 page-locked memory,device buffer 使用 cudaMalloc 分配;输入通过 cudaMemcpy 传给 GPU,Kernel 执行完成后再把结果复制回来:
void explicitMemExample(int vectorLength)
{
    float *A = nullptr, *B = nullptr, *C = nullptr;
    float *devA = nullptr, *devB = nullptr, *devC = nullptr;

    float* comparisonResult =
        (float*)malloc(vectorLength * sizeof(float));

    cudaMallocHost(&A, vectorLength * sizeof(float));
    cudaMallocHost(&B, vectorLength * sizeof(float));
    cudaMallocHost(&C, vectorLength * sizeof(float));

    initArray(A, vectorLength);
    initArray(B, vectorLength);

    cudaMalloc(&devA, vectorLength * sizeof(float));
    cudaMalloc(&devB, vectorLength * sizeof(float));
    cudaMalloc(&devC, vectorLength * sizeof(float));

    cudaMemcpy(devA, A,
               vectorLength * sizeof(float),
               cudaMemcpyDefault);

    cudaMemcpy(devB, B,
               vectorLength * sizeof(float),
               cudaMemcpyDefault);

    cudaMemset(devC, 0, vectorLength * sizeof(float));

    int threads = 256;
    int blocks = cuda::ceil_div(vectorLength, threads);

    vecAdd<<<blocks, threads>>>(
        devA, devB, devC, vectorLength);

    cudaDeviceSynchronize();

    cudaMemcpy(C, devC,
               vectorLength * sizeof(float),
               cudaMemcpyDefault);

    serialVecAdd(A, B, comparisonResult, vectorLength);

    if (vectorApproximatelyEqual(C, comparisonResult, vectorLength))
        printf("Explicit Memory: CPU and GPU answers match\n");

    cudaFree(devA);
    cudaFree(devB);
    cudaFree(devC);

    cudaFreeHost(A);
    cudaFreeHost(B);
    cudaFreeHost(C);

    free(comparisonResult);
}
对应的 main() 同样读取 vector 长度,然后调用:
explicitMemExample(vectorLength);
这两个示例可以直接使用 nvcc 编译和运行:
nvcc vecAdd_unifiedMemory.cu -o vecAdd_unifiedMemory
./vecAdd_unifiedMemory
./vecAdd_unifiedMemory 4096

nvcc vecAdd_explicitMemory.cu -o vecAdd_explicitMemory
./vecAdd_explicitMemory
./vecAdd_explicitMemory 4096
正常情况下,两种版本都会得到 CPU 与 GPU 计算结果一致的输出。
以上示例中,每个 Thread 都执行彼此独立的工作,因此 Thread 之间不需要协调或同步。但实际程序中,Thread 经常需要相互协作和通信。一个 Block 内的 Thread 可以通过 Shared Memory 共享数据,并通过同步来协调对内存的访问。
Block 级最基本的同步机制是 intrinsic:
__syncthreads();
它是一个 barrier(屏障):Block 中所有 Thread 都必须到达该位置之后,任何 Thread 才能继续执行。Shared Memory 被设计为靠近处理器核心的低延迟内存,类似于 L1 cache,因此 __syncthreads() 也被设计为相对轻量。需要特别注意:__syncthreads() 只能同步同一个 Thread Block 内的 Thread。
不同 Block 之间的同步只在特定条件下受到支持。例如,Thread Block Cluster 允许同一 Cluster 中的 Block 进行同步;Cooperative Groups API 也提供了创建跨 Block synchronization domain 的机制。
通常,将同步限制在 Thread Block 内部能够获得更好的性能。不同 Block 仍然可以通过 atomic memory functions 对共同结果进行操作。更细粒度、用于最大化性能与资源利用率的 CUDA synchronization primitives,会在 Section 3.2.4 中进一步介绍。
2.1.6 Runtime Initialization
CUDA Runtime 会为系统中的每个 device 创建一个 CUDA context。该 context 是此 device 的 primary context,会在第一次调用“需要该 device 上存在 active context”的 Runtime 函数时初始化。这个 context 由应用程序中的所有 host Thread 共享。创建 context 时,如果有需要,device code 会进行 JIT(just-in-time)编译并加载到 device memory;整个过程对应用程序透明。CUDA Runtime 创建的 primary context 也可以从 Driver API 访问,以实现 Runtime 与 Driver API 的互操作。
从 CUDA 12.0 开始,cudaInitDevice 和 cudaSetDevice 都会初始化 Runtime,以及与指定 device 关联的 primary context。如果在调用它们之前已经发生 Runtime API 请求,Runtime 会隐式使用 device 0,并根据需要自行初始化。因此,在测量 Runtime 函数耗时以及解释第一次 Runtime 调用返回的错误码时,需要考虑初始化开销。CUDA 12.0 之前,cudaSetDevice 不会初始化 Runtime。
cudaDeviceReset 会销毁当前 device 的 primary context。如果销毁后再次调用 CUDA Runtime API,则会为该 device 创建新的 primary context。
CUDA 接口依赖一些 global state,它们在 host 程序启动期间初始化,并在程序终止期间销毁。如果在程序初始化阶段,或 main 结束后的程序终止阶段,显式或隐式使用这些 CUDA 接口,将导致 undefined behavior。
从 CUDA 12.0 开始,cudaSetDevice 在改变当前 host Thread 所使用的 device 后,如果 Runtime 尚未初始化,会显式执行初始化。旧版本则会推迟到之后第一次 Runtime 调用。因此,必须检查 cudaSetDevice 的返回值,以捕获 Runtime 初始化错误。
Reference Manual 中属于 error handling 和 version management 部分的 Runtime 函数不会初始化 CUDA Runtime。
2.1.7 Error Checking in CUDA
每个 CUDA Runtime API 都返回枚举类型 cudaError_t。示例代码中经常为了简洁而省略错误检查,但在生产应用中,最佳实践是检查并处理每一次 CUDA API 调用的返回值。没有错误时返回 cudaSuccess。很多程序会定义类似下面的辅助宏:
#define CUDA_CHECK(expr_to_check) do {                  \
    cudaError_t result = expr_to_check;                 \
    if (result != cudaSuccess)                          \
    {                                                   \
        fprintf(stderr,                                 \
                "CUDA Runtime Error: %s:%i:%d = %s\n", \
                __FILE__,                               \
                __LINE__,                               \
                result,                                 \
                cudaGetErrorString(result));            \
    }                                                   \
} while (0)
这里使用 cudaGetErrorString() 将 cudaError_t 转换为便于阅读的错误描述。之后可以这样包装 Runtime API:
CUDA_CHECK(cudaMalloc(&devA, vectorLength*sizeof(float)));
CUDA_CHECK(cudaMalloc(&devB, vectorLength*sizeof(float)));
CUDA_CHECK(cudaMalloc(&devC, vectorLength*sizeof(float)));
发生错误时,宏会将信息输出到 stderr。这种宏在小型项目中很常见;大型应用通常会将它整合到自己的 logging 或 error-handling 系统中。需要特别注意:某个 CUDA API 返回的错误也可能来自之前提交的 asynchronous operation,而不一定来自当前 API 本身。
2.1.7.1 Error State
CUDA Runtime 为每个 host Thread维护一个 cudaError_t error state,初始值为 cudaSuccess,发生错误时会被覆盖。
cudaGetLastError();
返回当前 error state,随后将其重置为 cudaSuccess。
cudaPeekAtLastError();
同样返回当前 error state,但不会清除它。
使用 triple chevron:
kernel<<<blocks, threads>>>(...);
启动 Kernel 时本身不会返回 cudaError_t,因此最佳实践是在 kernel launch 后立即检查:
kernel<<<blocks, threads>>>(...);
CUDA_CHECK(cudaGetLastError());
此时得到 cudaSuccess 并不代表 Kernel 已成功执行,甚至不代表 Kernel 已经开始执行。它只说明 launch parameters / execution configuration 没有立即触发错误,并且开始 Kernel 之前没有遗留的错误状态。
2.1.7.2 Asynchronous Errors
Kernel launch 和许多 Runtime API 都是 asynchronous 的,因此异步操作执行期间发生的错误,通常要等到下一次检查 CUDA error state 时才会被报告,例如:
cudaGetLastError();
cudaPeekAtLastError();
或者任意返回 cudaError_t 的 CUDA API。
Runtime API 返回错误时,error state 不会自动清除。因此,例如 Kernel 发生 invalid memory access 后,该 asynchronous error 可能在后续 CUDA API 中反复返回,直到调用:
cudaGetLastError();
清除该状态。典型检查方式为:
vecAdd<<<blocks, threads>>>(devA, devB, devC);

// 检查 kernel launch 本身
CUDA_CHECK(cudaGetLastError());

// 等待 kernel 完成;执行期间发生的错误会在这里被报告
CUDA_CHECK(cudaDeviceSynchronize());
另外,cudaStreamQuery 和 cudaEventQuery 可能返回:
cudaErrorNotReady
它表示操作尚未完成,不被视为真正的错误,因此不会由 cudaPeekAtLastError() 或 cudaGetLastError() 报告。
2.1.7.3 CUDA_LOG_FILE
另一种识别 CUDA 错误的方法是环境变量:
CUDA_LOG_FILE
设置它之后,CUDA Driver 会把检测到的错误写入指定文件。例如下面的 Kernel launch 使用了非法的 Thread Block 大小:
__global__ void k()
{ }

int main()
{
    k<<<8192, 4096>>>(); // Invalid block size
    CUDA_CHECK(cudaGetLastError());
    return 0;
}
编译运行:
nvcc errorLogIllustration.cu -o errlog
./errlog
程序中的错误检查会报告 invalid argument。如果设置:
env CUDA_LOG_FILE=cudaLog.txt ./errlog
cat cudaLog.txt
Driver log 会提供更具体的信息,例如指出 Block dimension (4096,1,1) 超过最大值 (1024,1024,64)。
也可以设置:
CUDA_LOG_FILE=stdout
CUDA_LOG_FILE=stderr
直接输出到标准输出或标准错误。CUDA_LOG_FILE 即使在应用程序本身没有正确检查 CUDA 返回值时,也能帮助定位错误,因此非常适合 debugging;但它本身不能让应用程序在运行时处理并从 CUDA 错误中恢复。
CUDA 的 error log management 还允许向 Driver 注册 callback,在检测到错误时调用,从而与应用自身的 logging 系统集成。Error log management 和 CUDA_LOG_FILE 要求 NVIDIA Driver r570 或更高版本。
2.1.8 Device and Host Functions
__global__ 用于标记 Kernel 的入口函数,即会在 GPU 上并行执行的函数。通常 Kernel 从 host 启动,但通过 dynamic parallelism,也可以从另一个 Kernel 内部启动 Kernel。
__device__ 表示函数需要编译为 GPU code,并且可以从其他 __device__ 或 __global__ 函数调用。
函数也可以同时指定:
__host__ __device__
此时编译器会同时生成 CPU 版本和 GPU 版本。这同样适用于普通函数、class member function、functor 和 lambda。
2.1.9 Variable Specifiers
CUDA specifier 可以用于 static variable declaration,以控制变量放置在哪个 memory space:
__device__:变量存储在 Global Memory__constant__:变量存储在 Constant Memory__managed__:变量存储为 Unified Memory__shared__:变量存储在 Shared Memory
在 __device__ 或 __global__ 函数内部声明、且没有使用上述 specifier 的变量,会在可能时分配到 register,必要时分配到 local memory。
在 __device__ / __global__ 函数之外声明且没有这些 specifier 的变量,则分配在 system memory 中。
2.1.9.1 Detecting Device Compilation
当函数声明为:
__host__ __device__
时,编译器需要分别生成 CPU 和 GPU 版本。有时需要通过 preprocessor,让某段代码只出现在 device 版本或 host 版本中。最常见的方法是检查 __CUDA_ARCH__ 是否定义:
__host__ __device__ void func()
{
#if __CUDA_ARCH__ >= 800
    // Device code path for compute capability 8.x
#elif __CUDA_ARCH__ >= 700
    // Device code path for compute capability 7.x
#elif __CUDA_ARCH__ >= 600
    // Device code path for compute capability 6.x
#elif __CUDA_ARCH__ >= 500
    // Device code path for compute capability 5.x
#elif !defined(__CUDA_ARCH__)
    // Host code path
#endif
}
__CUDA_ARCH__ 在 device compilation 时定义,因此可以用它区分 CPU 与不同 GPU architecture 对应的代码路径。
2.1.10 Thread Block Clusters
从 Compute Capability 9.0 开始,CUDA 编程模型增加了一个可选层级:Thread Block Cluster。一个 Cluster 由多个 Thread Block 组成。
类似于一个 Thread Block 中的 Thread 保证被共同调度到一个 SM 上,一个 Cluster 中的 Thread Block 也保证被共同调度到 GPU 的同一个 GPC(GPU Processing Cluster) 上。Cluster 与 Block 类似,也可以组织成一维、二维或三维结构。
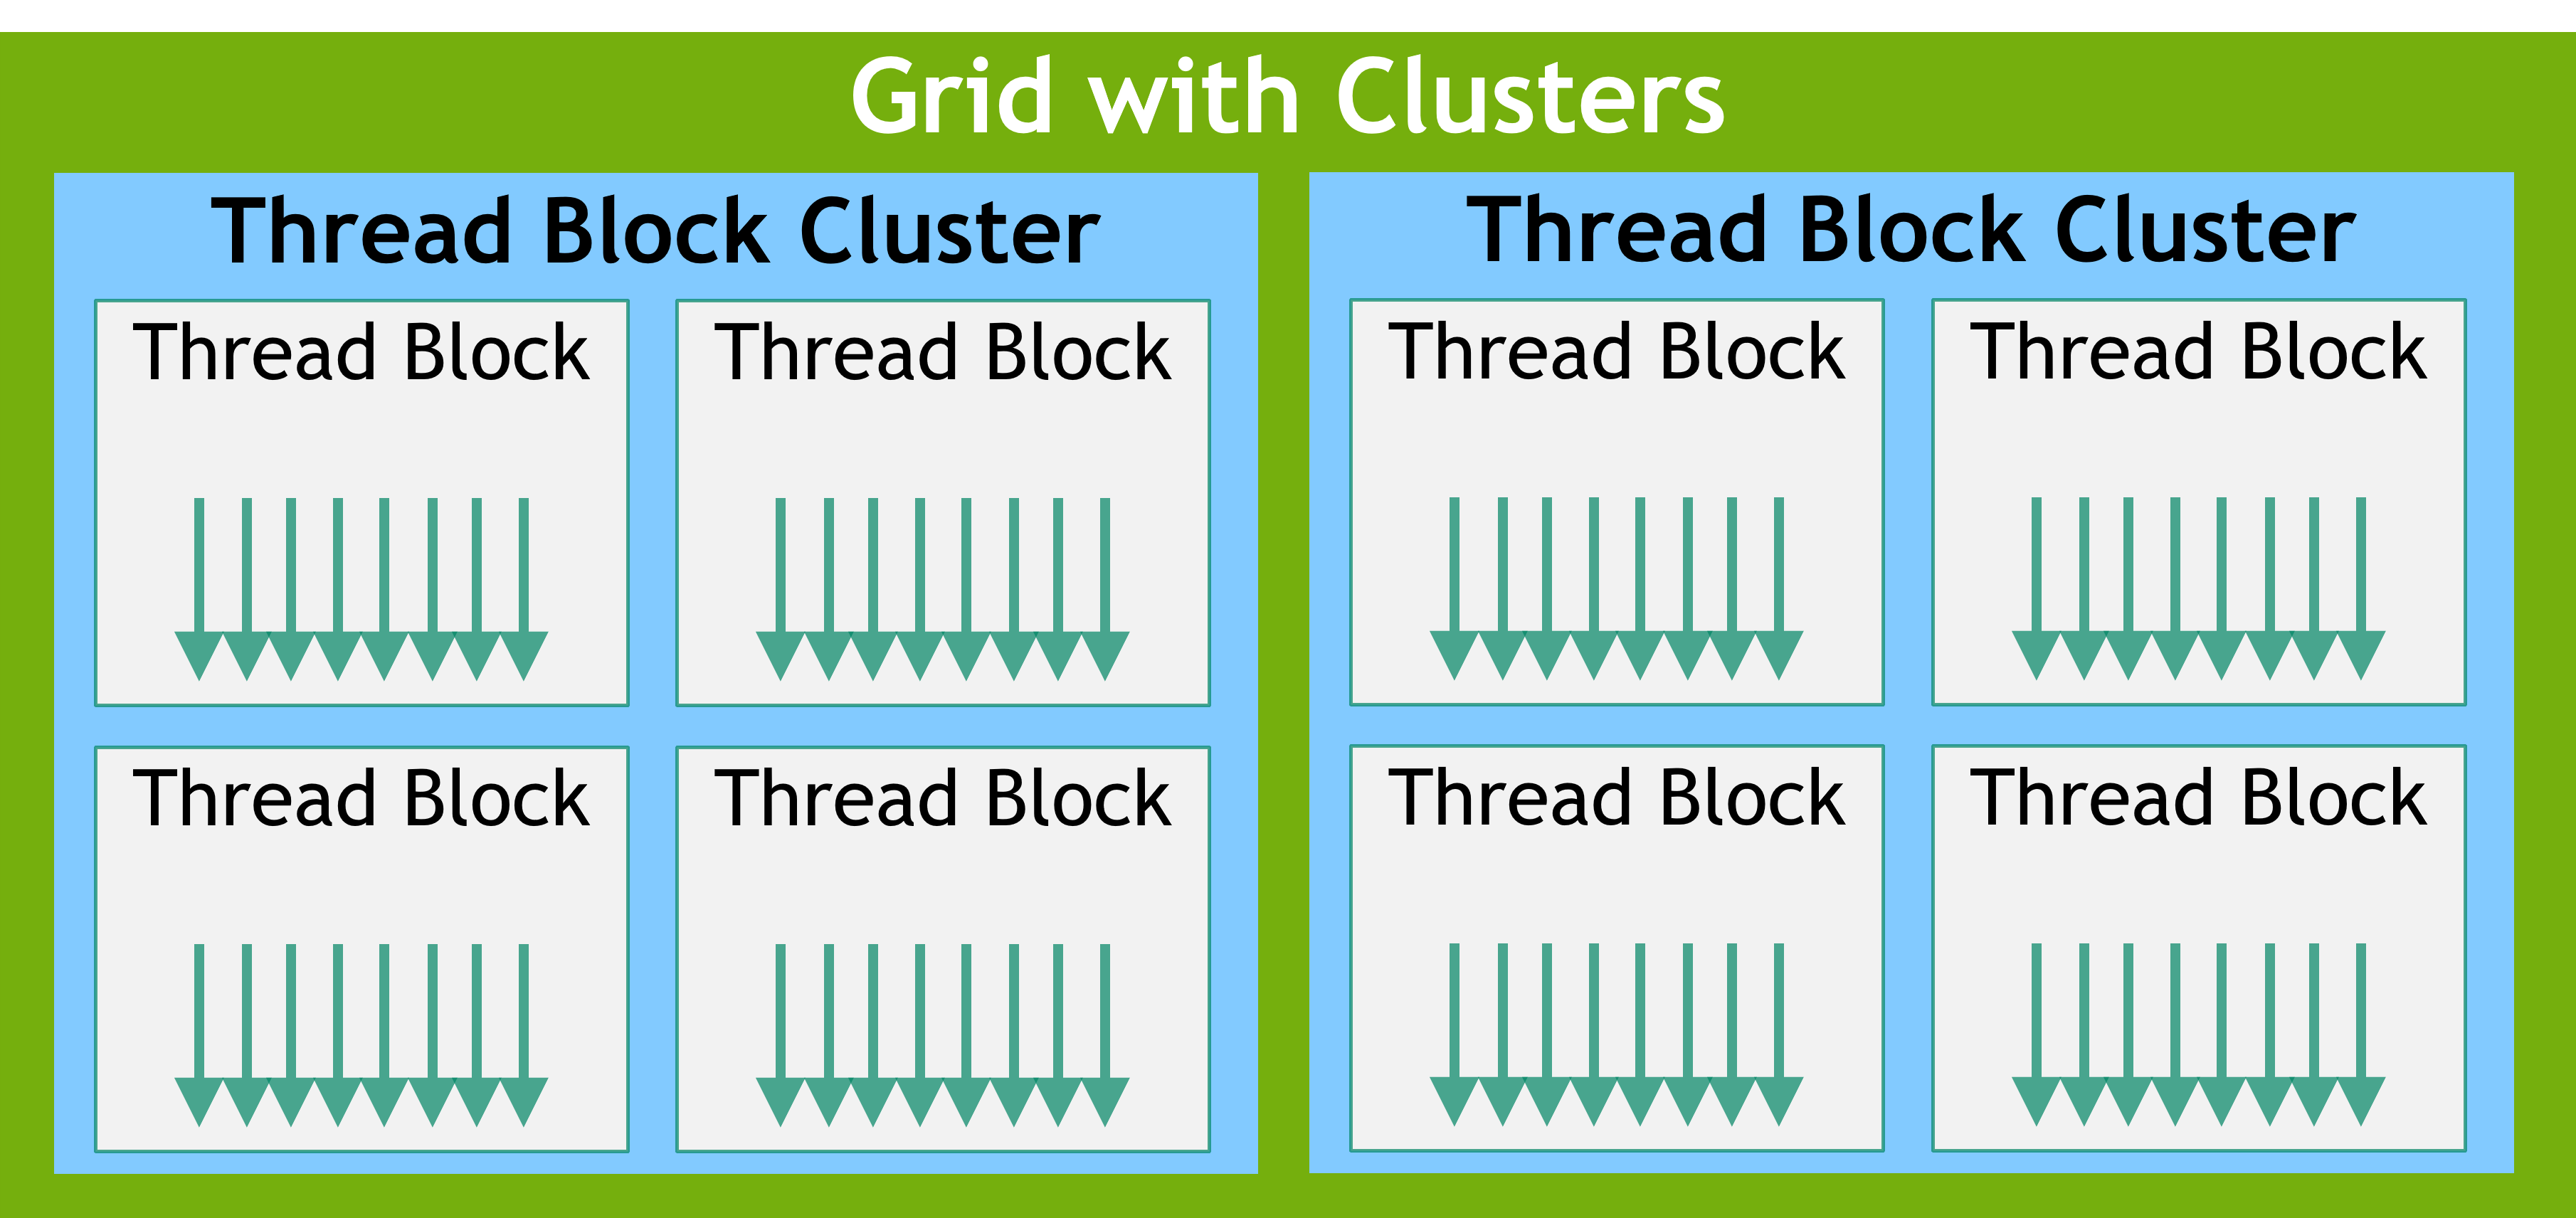
Figure 5: 指定 Cluster 后,Thread Block 在 Grid 中的位置保持不变,同时每个 Block 还具有它在所属 Cluster 内的位置。
Cluster 中包含多少个 Thread Block 可以由用户指定。CUDA 保证可移植的最大 Cluster size 为:
8 Thread Blocks
但如果 GPU 或 MIG configuration 太小,无法支持 8 个 multiprocessor,则最大 Cluster size 会相应降低。某些更大的硬件配置也可能支持 超过 8 个 Block 的 Cluster。实际支持的最大值与 architecture 有关,可以使用:
cudaOccupancyMaxPotentialClusterSize()
查询。
一个 Cluster 中的所有 Thread Block 保证在同一个 GPC 上同时 co-scheduled,因此可以通过 Cooperative Groups 提供的:
cluster.sync();
执行硬件支持的 Cluster synchronization。
Cluster group 还提供用于查询 Thread / Block 数量以及维度或位置相关信息的接口,例如:
num_threads()
num_blocks()
dim_threads()
dim_blocks()
Cluster 内的 Thread Block 还可以访问 Distributed Shared Memory(DSM)。DSM 是 Cluster 中所有 Thread Block 的 Shared Memory 的组合;Cluster 中的 Block 可以对其中任意地址执行 read、write 和 atomic operation。
使用 Cluster 启动 Kernel 时,为了兼容原有 CUDA 编程模型,gridDim 仍然表示 Thread Block 的数量,而不是 Cluster 的数量。Block 在 Cluster 内的 rank 可以通过 Cooperative Groups API 获得。
2.1.10.1 Launching with Clusters in Triple Chevron Notation
Kernel 可以通过两种方式启用 Thread Block Cluster:
- compile-time Kernel attribute:
__cluster_dims__(X, Y, Z)
- Kernel launch API:
cudaLaunchKernelEx
使用 compile-time attribute 时,Cluster size 在编译期确定,之后仍可以使用传统:
<<< , >>>
方式启动 Kernel。但编译期指定的 Cluster size 在 launch 时不能修改。
例如:
// Kernel definition
// Compile time cluster size 2 in X-dimension
// and 1 in Y and Z dimensions
__global__ void __cluster_dims__(2, 1, 1)
cluster_kernel(float *input, float *output)
{

}

int main()
{
    float *input, *output;

    dim3 threadsPerBlock(16, 16);
    dim3 numBlocks(N / threadsPerBlock.x, N / threadsPerBlock.y);

    // Grid dimension仍然按照Block数量表示
    // Grid dimension必须是Cluster size的整数倍
    cluster_kernel<<<numBlocks, threadsPerBlock>>>(input, output);
}
这里:
__cluster_dims__(2, 1, 1)
表示每个 Cluster 在 X 方向包含 2 个 Thread Block,Y、Z 方向各为 1。
需要注意,即使启用了 Cluster:
numBlocks
仍然表示 Grid 中 Thread Block 的数量,而不是 Cluster 数量。此外,Grid dimensions 必须是 Cluster dimensions 的整数倍。